
1. Introduction : pourquoi l’IA seule ne suffit pas toujours ?
L'IA écrit avec une fluidité étonnante.
Elle peut expliquer une notion complexe, résumer un rapport, rédiger un brouillon de message client ou aider à structurer une stratégie. Mais beaucoup connaissent désormais sa principale faiblesse : elle peut répondre avec assurance même lorsqu'elle manque d'informations. Elle a l'air d'un expert alors qu'elle devine.
Dans le monde du travail, c'est un problème particulièrement lourd. En entreprise, on n'attend généralement pas de l'IA un joli texte. On attend des réponses fondées sur de vrais documents, des informations à jour, des consignes internes, des données clients ou des sources fiables.
C'est pour répondre à ce besoin qu'est né le RAG, ou Retrieval-Augmented Generation.
En français, on pourrait le traduire, un peu lourdement, par « génération augmentée par la recherche ». Concrètement, il s'agit d'une technique où l'IA ne répond pas seulement à partir de sa mémoire ou de ses données d'entraînement : elle commence par chercher l'information dans une source définie, puis construit sa réponse à partir de celle-ci.
Google Cloud décrit le RAG comme un cadre d'IA qui associe la recherche d'information classique, par exemple les moteurs de recherche et les bases de données, à la capacité des modèles de langage génératifs à produire du langage naturel. L'objectif est de rendre les réponses plus précises, plus à jour et mieux adaptées au besoin propre de l'utilisateur.[1]
Plus simplement : le RAG donne à l'IA une carte de bibliothèque. Au lieu de répondre uniquement de mémoire, le modèle peut vérifier les informations pertinentes avant de formuler sa réponse.
2. Que signifie RAG ?
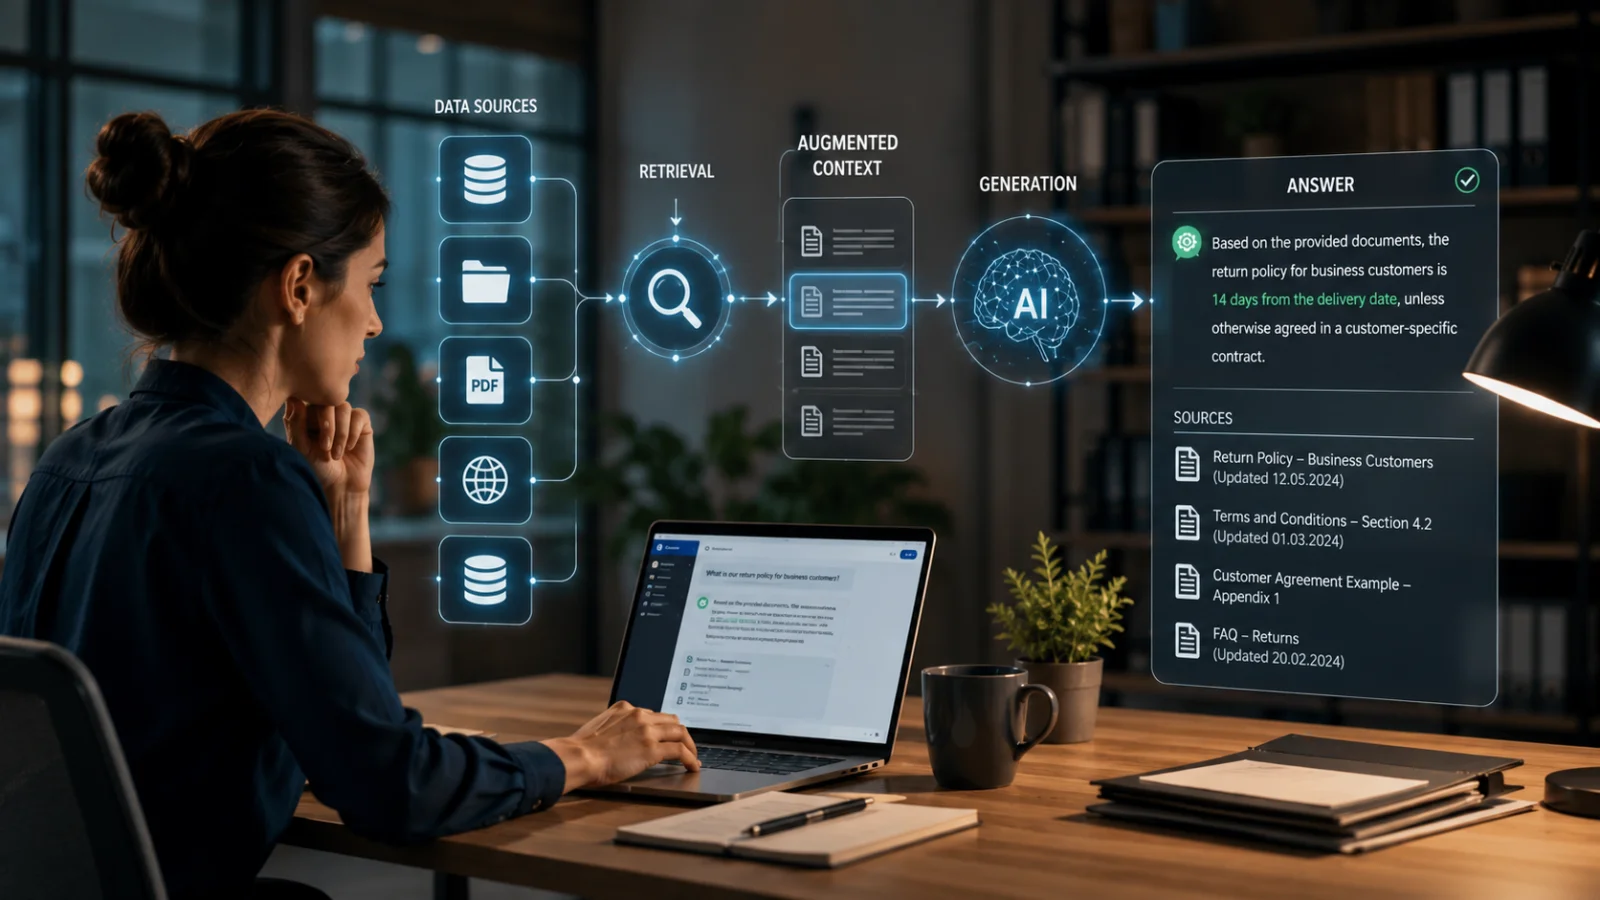
RAG signifie Retrieval-Augmented Generation. La technique repose sur trois idées :
Retrieval — la recherche d'information
Le système cherche dans une source externe les informations liées à la question de l'utilisateur. Cette source peut être par exemple :
- la base de connaissances interne de l'entreprise
- documentation produit
- consignes du support client
- intranet
- modèles de contrats
- rapports de recherche
- sites web
- une base de données
- Documents PDF
- un système CRM ou ERP
- questions fréquentes
- supports de formation
Augmented — augmenté
L'information récupérée est ajoutée au contexte de l'IA. Le modèle reçoit donc, en plus de la question de l'utilisateur, les documents qui s'y rapportent.
Generation — la production de la réponse
Le modèle de langage formule la réponse à l'utilisateur à partir des informations récupérées.
Amazon Web Services définit le RAG comme une manière d’optimiser la sortie d’un grand modèle de langage en l’amenant à s’appuyer sur une base de connaissances faisant autorité, extérieure à ses données d’entraînement. Le modèle produit ainsi des réponses plus précises et plus exploitables.[2]
La différence essentielle avec une réponse d'IA ordinaire est la suivante :
Sans RAG, le modèle répond à partir de ce qu'il a appris pendant son entraînement et de ce que l'utilisateur lui donne dans la conversation. Avec le RAG, il dispose en plus d'informations récupérées, plus précises et souvent plus à jour, sur la question posée.
3. Pourquoi le RAG est-il apparu ?
Le RAG est né pour résoudre un problème fondamental de l'IA générative : les modèles de langage sont impressionnants, mais leurs connaissances ne sont pas automatiquement à jour, vérifiées ni propres à une organisation.
Un grand modèle de langage peut connaître beaucoup de choses générales. Il peut expliquer ce qu'est la trésorerie, comment fonctionne une activité SaaS ou pourquoi la fidélisation compte. Mais il ne sait pas nécessairement :
- ce qui figure précisément dans les notices produit de votre entreprise
- quel est le tarif le plus récent
- ce qui a été décidé dans les documents du conseil d'administration de la semaine dernière
- quelle est la procédure du support client aujourd'hui
- ce qu'autorise la politique de sécurité de l'organisation
- en quoi une version de contrat diffère de la précédente
- ce que dit l'instruction officielle en vigueur
IBM Research décrit le RAG comme une approche « open book » : le modèle ne passe pas un examen à livre fermé, il peut s'appuyer sur des sources externes pour étayer sa réponse. Selon IBM, les deux bénéfices majeurs du RAG sont l'accès à des faits actuels et fiables, et la possibilité pour l'utilisateur de voir sur quelles sources la réponse repose.[3]
C'est un grand changement. Un modèle de langage classique ressemble à un généraliste brillant, qui retient beaucoup mais peut confondre des détails. Un modèle RAG, c'est le même expert avec les bons documents sous les yeux.
4. Comment fonctionne le RAG en pratique ?
Le fonctionnement d'un système RAG peut se décrire en cinq étapes.
1. L’information est collectée
On commence par importer des contenus dans le système, par exemple :
- des documents de l'entreprise
- du contenu de sites web
- des consignes
- des articles de la base de connaissances
- des descriptions de produits
- des réponses du support client
- des descriptions de processus internes
Cette étape est souvent appelée ingestion des données, c'est-à-dire l'entrée des informations dans le système.
2. L’information est découpée en morceaux
Les documents longs sont découpés en parties plus petites, souvent appelées chunks. Un chunk est un extrait de texte de taille adaptée, par exemple quelques paragraphes ou une partie de page.
C'est important, car il n'est généralement pas judicieux que l'IA lise toute la bibliothèque documentaire à chaque question. Elle doit retrouver exactement les bons passages.
3. L’information est indexée
Les fragments de documents sont convertis dans un format qui permet de les rechercher efficacement. On utilise souvent ce que l'on appelle des embeddings. Un embedding est une représentation numérique du texte : le système transforme le texte en une « empreinte » mathématique qui permet de retrouver des contenus similaires.
Ces représentations sont souvent stockées dans une base de données vectorielle. Il s'agit d'une base conçue pour retrouver des contenus proches par le sens, et pas seulement des mots strictement identiques.
4. Les contenus pertinents sont recherchés en réponse à la question posée
Lorsqu'un utilisateur pose une question, le système recherche dans la base les fragments de texte qui s'y rapportent. Si la question est :
« Comment fonctionne notre politique de retour pour les clients professionnels ? »
Un système RAG peut récupérer les conditions de retour, la procédure du service client et, le cas échéant, une annexe au contrat.
5. Le modèle de langage formule la réponse à partir des sources
Enfin, le modèle de langage reçoit la question de l'utilisateur et les fragments de texte récupérés. Sa tâche est d'en tirer une réponse claire.
Dans la description du Vertex AI RAG Engine de Google Cloud, le processus suit la même logique : les données sont importées dans le système, converties et découpées, indexées, récupérées en fonction de la question de l'utilisateur, puis fournies au modèle comme contexte. Google souligne que ce contexte supplémentaire aide le modèle à répondre plus précisément et réduit les hallucinations.[4]
5. Le RAG expliqué par une comparaison simple
Imaginons deux experts.
Le premier expert est assis dans une salle de réunion, sans aucun document. Il a beaucoup lu et sait parler avec assurance. Quand on lui pose une question, il répond de mémoire. Souvent, la réponse est bonne. Mais si on l'interroge sur le dernier tarif, sur une clause précise du contrat ou sur une décision prise cette semaine, il peut se tromper.
Le second expert est assis dans la même pièce, mais il a accès aux documents de l'entreprise, aux consignes récentes et à un moteur de recherche. Quand on lui pose une question, il commence par retrouver le bon passage et répond sur cette base.
C'est l'idée du RAG. Il ne rend pas l'IA infaillible. Mais il lui donne une meilleure base de travail.
NVIDIA compare le RAG à un auxiliaire de justice : un grand modèle de langage ressemble à un juge doté d'une compréhension générale, mais un dossier précis exige des pièces, des précédents et des sources. Le RAG joue le rôle du « bibliothécaire » qui va chercher pour le modèle le matériel nécessaire.[5]
La comparaison est juste, car elle met au jour le cœur du RAG : une bonne réponse ne naît pas de la seule intelligence. Elle naît de la bonne information au bon moment.
6. Comment le RAG réduit-il les hallucinations ?
On parle d'hallucination lorsque l'IA produit une information crédible mais fausse ou inventée. Le RAG réduit les hallucinations, car il ancre la réponse dans les documents récupérés.
Sans RAG, l'IA peut répondre ceci :
« Votre délai de retour est de 30 jours. »
Avec le RAG, la réponse peut s'appuyer sur un document :
« Pour les clients professionnels, le délai de retour est de 14 jours selon les conditions contractuelles, sauf stipulation contraire du contrat conclu avec le client. »
La différence est énorme. Le RAG aide surtout de trois manières.
1. Le modèle dispose d’une base factuelle
Quand le modèle reçoit le document pertinent, il n'a pas besoin d'inventer une réponse à partir de rien.
2. La réponse peut être sourcée
Un bon système RAG montre sur quel document ou quel passage la réponse s'appuie.
3. L’utilisateur peut vérifier les affirmations
Les sources rendent la réponse plus facile à auditer. L'utilisateur peut ouvrir le document d'origine et vérifier si la réponse tient.
Microsoft met en avant deux bénéfices du RAG : moins d'hallucinations et une meilleure transparence des sources. Selon Microsoft, le RAG peut renforcer la confiance en particulier dans les domaines à haut risque comme le droit, la santé et la finance, puisque l'utilisateur peut vérifier sur quoi reposent les affirmations.↗[6]
Une remarque importante toutefois : le RAG n'élimine pas totalement les hallucinations. Il réduit le risque, à condition que la recherche trouve la bonne information et que le modèle l'utilise correctement.
7. Pourquoi le RAG garde-t-il les réponses plus à jour ?
Un grand modèle de langage a été entraîné sur un corpus donné jusqu'à une date donnée. Ses connaissances internes peuvent vieillir. Le RAG résout ce problème en reliant le modèle à des sources externes que l'on peut mettre à jour sans réentraîner tout le modèle.
Pour les entreprises, c'est un avantage énorme.
Si le tarif change, il n'est pas nécessaire d'entraîner un nouveau modèle de langage — on met à jour le document tarifaire ou la base de données. Si une procédure de support change, on met à jour la procédure. Si la législation change, on met à jour les sources.
IBM cite parmi les bénéfices du RAG l'accès à des données actuelles et sectorielles, ainsi que la possibilité pour les organisations d'améliorer les réponses de l'IA sans réentraîner le modèle à grands frais.[7]
C'est là que la force pratique du RAG apparaît. L'IA n'est plus seulement un modèle qui « sait ce qu'il sait ». Elle devient l'interface d'une base de connaissances vivante.
8. Le RAG dans les entreprises et les organisations
En entreprise, le RAG est l'un des principaux moyens de rendre l'IA générative réellement utile. Pourquoi ? Parce que la valeur d'une entreprise ne tient généralement pas aux connaissances générales. Elle tient à ses propres données, ses propres processus, ses propres clients et ses propres documents.
Le RAG peut aider par exemple dans les cas d'usage suivants :
Service client
Un chatbot peut répondre aux questions des clients en s'appuyant sur les guides internes, les conditions contractuelles et les fiches produits de l'entreprise.
Ventes
Un commercial peut demander à l'IA :
« Que faut-il retenir de ce client avant le rendez-vous ? »
Le RAG peut récupérer des notes du CRM, d'anciens devis, des demandes de support et des informations sur le segment client.
RH
Un collaborateur peut demander :
« Comment fonctionne le congé parental dans notre entreprise ? »
Le RAG peut retrouver la réponse dans les règles RH et, le cas échéant, dans les pratiques locales.
Juridique et conformité
Un juriste ou une équipe conformité peut retrouver des clauses contractuelles, des lignes directrices réglementaires et des politiques internes.
Développement produit
L'équipe produit peut analyser les retours clients, les demandes de support et les documents de roadmap.
Formation
Un nouveau collaborateur peut poser des questions sur les façons de faire de l'organisation et obtenir des réponses fondées sur les supports d'intégration.
Amazon Web Services décrit le RAG comme une manière pragmatique et efficace d’utiliser les modèles de langage en entreprise, car il fournit au modèle des données externes — les documents internes de l’entreprise, par exemple — grâce auxquelles les réponses collent mieux à un cas d’usage précis.[8]
C'est là le cœur business du RAG : il fait passer l'IA du statut de rédacteur généraliste à celui d'interface du travail intellectuel de l'organisation.
9. Le RAG dans les assistants IA : que faut-il comprendre en tant qu’utilisateur ?
Le conseil pratique est le suivant :
Un assistant IA fondé sur le RAG appuie ses réponses sur des informations à jour.
C’est une promesse importante pour l’utilisateur, mais encore faut-il bien la comprendre. Le RAG signifie que l’assistant IA peut rechercher des informations dans des sources définies avant de formuler sa réponse. L’utilisateur n’obtient donc pas une simple supposition d’un modèle de langage généraliste, mais une réponse fondée sur la base de connaissances dont dispose le système.
Concrètement, cela peut par exemple signifier qu’un assistant IA fondé sur le RAG :
- va chercher l'information dans les documents propres à l'organisation
- utilise des consignes à jour
- renvoie aux documents sources
- réduit le risque de réponses inventées
- peut répondre à des questions propres à l'organisation
- aide l'utilisateur à trouver plus vite la bonne information
Il faut cependant le dire honnêtement : le RAG ne rend aucun système d’IA automatiquement parfait. Dans une solution RAG, la qualité du résultat dépend entre autres des éléments suivants :
- la qualité de la base de connaissances
- à quel point les sources sont à jour
- si la recherche trouve les bons documents
- si le modèle sait utiliser correctement l'information récupérée
- si les sources sont affichées à l'utilisateur
- comment agir en cas d'incertitude
Un bon système RAG ne se contente pas de répondre. Il aide l'utilisateur à voir sur quoi la réponse repose.
C’est pourquoi, avec un assistant IA fondé sur le RAG, il vaut la peine de demander :
« Montre-moi sur quelle source repose cette réponse. »
Ou :
« Si la réponse ne figure pas dans les sources fournies, dis-le franchement. »
Cela rend l'usage de l'IA plus sûr et plus transparent.
10. Les avantages du RAG : pourquoi en parle-t-on autant ?
Le RAG est rapidement devenu l'une des techniques clés de l'IA générative, parce qu'il s'attaque directement à ses points faibles concrets.
10.1 Moins d’hallucinations
Quand la réponse s'appuie sur des documents récupérés, le modèle devine moins.
10.2 Des informations plus à jour
La base de connaissances peut être mise à jour sans réentraîner le modèle.
10.3 Un savoir propre à l’organisation
Le RAG peut exploiter les données propres à l'entreprise, que le modèle de langage généraliste ne connaît pas.
10.4 Une meilleure transparence
Les références et les liens vers les documents aident l'utilisateur à vérifier la réponse.
10.5 Des coûts mieux maîtrisés
Le RAG peut être une option plus légère que le fine-tuning continu ou le réentraînement du modèle.
10.6 Trouver l’information plus vite
L'utilisateur n'a pas à chercher lui-même le bon PDF, la bonne page d'intranet ou la bonne consigne.
10.7 Une meilleure expérience client
Un bot de service client peut donner des réponses plus précises s’il s’appuie sur les vraies consignes de l’entreprise.
Google Cloud décrit le RAG comme la combinaison des données propres à l'organisation et des capacités linguistiques des modèles de langage, ce qui rend les réponses plus précises, plus à jour et plus pertinentes pour l'utilisateur.[1]
En ce sens, le RAG est une sorte de contrôle de réalité pour l'IA. Il ne produit pas simplement du texte — il commence par aller chercher le terrain sur lequel ce texte sera bâti.
11. Les limites du RAG : pourquoi ce n’est pas une solution miracle ?
Le RAG est puissant, mais il n'a rien de magique. Il peut échouer de bien des façons.
11.1 La recherche peut remonter la mauvaise information
Si le système récupère le mauvais document ou le mauvais passage, la réponse peut être fausse. C'est le problème classique du RAG : la génération est bonne, mais le retrieval, c'est-à-dire la recherche, échoue.
11.2 L’information peut être obsolète
Le RAG ne garde les réponses à jour que si la base de connaissances l'est. Si une consigne périmée s'y trouve, l'IA peut répondre selon cette consigne périmée.
11.3 Les documents peuvent se contredire
S'il existe dans l'organisation trois versions différentes de la même procédure, le RAG peut récupérer la mauvaise ou les mélanger.
11.4 Le modèle peut mal interpréter la source
Même quand le bon document est retrouvé, le modèle de langage peut le comprendre de travers ou trop généraliser.
11.5 La source ne suffit pas toujours pour répondre
Si le contexte récupéré ne contient pas assez d'informations, le modèle devrait dire « je ne sais pas ». Tous les systèmes ne le font pas bien.
Google Research a mis en avant la notion de sufficient context, c'est-à-dire de contexte suffisant. Dans un système RAG, il ne suffit pas que l'information récupérée soit vaguement pertinente. Elle doit être suffisante pour répondre correctement à la question. Si le contexte ne suffit pas, le modèle devrait plutôt reconnaître son incertitude que d'inventer une réponse.[9]
C'est une prise de conscience importante. Le RAG n'est pas seulement un moteur de recherche plus une IA. C'est une question de qualité : retrouve-t-on précisément l'information qui suffit à donner la bonne réponse ?
11.6 Le RAG peut donner un faux sentiment de sécurité
Quand une réponse comporte des références, elle paraît fiable. Mais une référence ne garantit pas automatiquement que la réponse est juste. La source peut être erronée, obsolète ou mal interprétée. L'utilisateur doit donc continuer de vérifier les affirmations critiques.
12. Comment construire un bon système RAG ?
Un bon système RAG ne naît pas simplement en branchant un modèle de langage sur un dossier de documents. Il demande une conception soignée.
12.1 Une base de connaissances de qualité
La première question est : quelles informations donne-t-on au système ? Si la base de connaissances est confuse, obsolète ou contradictoire, les réponses s'en ressentent. Une bonne base de connaissances est :
- à jour
- sélectionnée
- clairement structuré
- versionnée
- tenue à jour par des responsables désignés
- avec des droits d'accès maîtrisés
12.2 Un bon découpage des documents
Si les documents sont découpés en morceaux trop petits, le contexte se perd. S'ils sont trop gros, la recherche devient imprécise. Le chunking est un choix technique étonnamment important. Il détermine si le système trouve ou non le bon passage.
12.3 Une méthode de recherche efficace
La seule recherche par mots-clés ne suffit pas toujours. La recherche vectorielle trouve des contenus proches par le sens, même si les mots ne sont pas identiques. La meilleure solution est souvent une recherche hybride, qui combine recherche par mots-clés et recherche sémantique.
12.4 L’affichage des sources
L'utilisateur doit pouvoir voir sur quoi repose la réponse. Une bonne réponse RAG peut comporter :
- le nom du document
- le passage ou la page
- un lien vers la source
- une brève justification
- l'incertitude, si la source ne suffit pas
12.5 Des instructions claires pour le modèle
Il faut indiquer au modèle comment il doit se comporter. Par exemple :
« Réponds uniquement à partir des sources fournies. Si elles ne contiennent pas la réponse, dis-le franchement. »
Cela réduit la part de devinette.
12.6 Évaluation et tests
Un système RAG doit être testé avec de vraies questions. Amazon Web Services insiste sur l'évaluation de la fiabilité des applications RAG : il vaut la peine de mesurer le système sous l'angle des performances, de la fiabilité et des biais éventuels.[10]
Lors des tests, il vaut la peine de se demander :
- Trouve-t-on la bonne source ?
- La réponse s'appuie-t-elle sur la source ?
- Le modèle s'abstient-il de répondre lorsque l'information manque ?
- Les sources sont-elles visibles pour l'utilisateur ?
- La réponse est-elle trop assurée ?
- Le système fonctionne-t-il pour tous les groupes d'utilisateurs ?
Un bon RAG est un processus continu, pas un projet ponctuel.
13. RAG ou fine-tuning : quand utiliser l’un ou l’autre ?
On confond souvent le RAG avec le fine-tuning d'un modèle. Ce sont deux choses différentes.
RAG
Le RAG fournit au modèle des informations externes au moment de répondre. Il convient quand :
- l'information change souvent
- vous souhaitez utiliser les documents de l'organisation
- les sources doivent être affichées
- les réponses doivent rester à jour
- vous souhaitez éviter de réentraîner le modèle
Fine-tuning
Le fine-tuning consiste à poursuivre l'entraînement du modèle sur un jeu de données précis ou pour une tâche précise. Il convient lorsque :
- vous souhaitez modifier le style du modèle
- vous souhaitez lui apprendre un format de réponse précis
- vous souhaitez améliorer les performances sur une tâche délimitée
- les données sont relativement stables
- un comportement spécifique est nécessaire, et pas seulement de nouvelles connaissances
Souvent, la meilleure solution n'est pas l'un ou l'autre. Une entreprise peut utiliser le RAG pour les informations à jour et le fine-tuning pour enseigner par exemple un style de réponse ou un processus donné.
Mais si le problème est « le modèle ne connaît pas nos consignes les plus récentes », le RAG est en général une solution plus naturelle que le fine-tuning.
14. L’avenir : du RAG vers les agents et les systèmes intelligents du travail intellectuel
Le RAG est déjà important, et il le sera plus encore à mesure que l'IA passe des simples chatbots aux agents.
Un agent est un système d’IA qui ne se contente pas de répondre à une question : il peut enchaîner plusieurs étapes — chercher des informations, comparer des options, utiliser des outils, élaborer un plan et parfois même exécuter des tâches.
Pour de tels agents, le RAG est une infrastructure de base. Si un agent doit aider un collaborateur, il lui faut savoir :
- ce que disent les consignes de l'organisation
- ce que le client a fait auparavant
- ce qui se passe dans les systèmes
- quelles règles doivent être respectées
- quels documents peuvent être utilisés
- sur quoi repose une information
IBM décrit l'approche agentic RAG, dans laquelle un système RAG se combine à des capacités agentiques : le système peut aller chercher de l'information dans une base de connaissances externe et l'utiliser pour produire des réponses plus précises et propres à un secteur, sans que le modèle ne s'appuie uniquement sur ses données d'entraînement.[11]
À l'avenir, le RAG ne sera peut-être plus visible pour l'utilisateur comme une technique à part. Il se verra dans la qualité des réponses.
L'utilisateur pose une question, et le système :
- récupère les bonnes sources
- évalue si elles suffisent
- formule la réponse
- affiche les sources
- signale l'incertitude
- propose l'action suivante
C'est un grand pas vers une IA qui ne se contente pas de paraître intelligente, mais qui fonctionne de façon plus fiable dans le travail quotidien.
15. Conclusions : que faut-il en retenir ?
Le RAG est l'une des techniques les plus importantes lorsqu'on amène l'IA générative dans le travail réel. Il résout trois grands problèmes :
- les connaissances de l'IA peuvent être périmées
- l'IA ne connaît pas les données propres à l'organisation
- l'IA peut halluciner de façon convaincante
Le RAG ne rend pas l'IA parfaite. Mais il la rend plus utilisable, plus vérifiable et mieux ancrée dans les informations réelles.
Voici les principaux enseignements :
1. Avec le RAG, l’IA cherche d’abord l’information et ne répond qu’ensuite
C'est ce qui le distingue d'une réponse ordinaire de modèle de langage.
2. Le RAG réduit les hallucinations, mais ne les supprime pas complètement
Une recherche erronée, une source périmée ou une mauvaise interprétation peuvent malgré tout mener à une erreur.
3. Les sources sont la grande force du RAG
Quand une réponse peut être rattachée à un document, l'utilisateur peut la vérifier.
4. L’actualité des réponses dépend de la base de connaissances
Le RAG ne vaut que ce que valent les données qu'il utilise.
5. En entreprise, le RAG est la clé pour exploiter le savoir interne
Il peut transformer l'intranet, un dossier de documents et une base de procédures en une interface conversationnelle.
6. Avec un assistant IA fondé sur le RAG, demandez à voir les sources
L'utilisateur a tout intérêt à demander : « Sur quoi repose cette réponse ? »
7. Le meilleur RAG sait parfois dire : « Je ne sais pas »
Un système fiable n'invente pas de réponse quand les sources sont insuffisantes.
Au fond, le RAG est simple : l'IA s'améliore quand elle n'a pas à répondre toute seule.
Quand un modèle dispose des bonnes informations, des bonnes sources et du bon contexte, il peut aider bien davantage qu'un simple chatbot généraliste. Ce n'est plus seulement une machine à produire du texte. C'est un assistant qui va chercher l'information, l'interprète et devient un véritable partenaire de travail — à condition que l'humain continue de questionner, de vérifier et d'exercer son propre jugement.
16. Des prompts concrets pour utiliser un système RAG
Voici des modèles de prompts utilisables avec n’importe quelle solution d’IA fondée sur le RAG.
16.1 Une réponse fondée sur les sources
Réponds uniquement à partir des sources disponibles.
Si la réponse ne figure pas dans les sources, dites : « Je ne trouve pas de réponse à cela dans les documents disponibles. »
Ajoute à la fin de la réponse les sources ou les documents sur lesquels elle repose.
16.2 Reconnaître l’incertitude
Réponds à la question à partir des sources. Distingue dans ta réponse :
1) ce que les sources affirment avec certitude
2) ce que l’on peut en déduire
3) ce que l’on ne peut pas déduire des documents fournis
16.3 Comparer des documents
Compare ces sources entre elles.
Repérez les contradictions, les redondances et les endroits où un document plus récent semble en remplacer un plus ancien.
Ne tire pas de conclusions que les sources n'étayent pas.
16.4 Une réponse de service client
Rédige pour le client une réponse claire à partir des documents sources.
Gardez un ton amical et professionnel.
Ne promets rien qui ne figure pas dans les sources.
Si un point exige une vérification humaine, dites-le clairement.
16.5 Aide à la décision
Faites une analyse concise de ce sujet à partir des sources fournies. Donnez :
• les faits essentiels
• risques éventuels
• questions ouvertes
• ce qu'il faudrait vérifier avant de déciderN'ajoute pas d'informations extérieures sans les signaler explicitement.
16.6 Vérifier une réponse RAG
Vérifiez votre réponse précédente.
Indique la source de chaque affirmation importante.
Si une affirmation ne repose pas sur une source, supprimez-la ou signalez-la comme une hypothèse.
En résumé
Si le prompt engineering apprend à mieux interroger l'IA, le RAG apprend à l'IA à répondre à partir de meilleures sources. La différence est décisive.
Une IA ordinaire peut sonner juste. Une IA basée sur le RAG peut montrer sur quoi repose sa réponse. C'est précisément ce qui en fait une technique si importante pour les entreprises, les experts et tous ceux qui veulent utiliser l'IA pour autre chose que la recherche d'idées.
Conseil pratique : quand vous utilisez un assistant IA fondé sur le RAG, demandez-lui d’afficher ses sources et de vous prévenir si la réponse ne figure pas dans les documents. C’est un petit geste qui installe une confiance bien plus solide dans l’usage de l’IA.
Sources
- What is Retrieval-Augmented Generation (RAG)? — Google Cloud
- What is RAG? Retrieval-Augmented Generation AI — Amazon Web Services
- What is retrieval-augmented generation (RAG)? — IBM Research
- Vertex AI RAG Engine overview — Google Cloud Documentation
- What Is Retrieval-Augmented Generation aka RAG — NVIDIA Blog
- 5 key features and benefits of retrieval augmented generation — Microsoft
- O que é RAG (retrieval-augmented generation)? — IBM
- Understanding Retrieval Augmented Generation — AWS Prescriptive Guidance
- Deeper insights into retrieval augmented generation — Google Research
- Evaluate the reliability of RAG applications — AWS Machine Learning Blog
- What is Agentic RAG? — IBM