
1. Inledning: varför räcker det inte alltid med enbart AI?
AI kan skriva förvånansvärt flytande.
Den kan förklara ett komplicerat begrepp, sammanfatta en rapport, skissa på ett kundmeddelande eller hjälpa till att forma en strategi. Men samtidigt har dess största svaghet blivit bekant för många: den kan svara självsäkert även när den saknar tillräcklig kunskap. Den kan låta som en expert trots att den gissar.
Detta är ett särskilt stort problem i arbetslivet. I företag vill man vanligtvis inte bara ha vacker text av AI:n. Man vill ha svar som bygger på rätt dokument, aktuell information, interna riktlinjer, kunddata eller tillförlitliga källor.
För detta behov uppstod RAG, det vill säga Retrieval-Augmented Generation.
På svenska skulle man klumpigt kunna översätta det till ”generering som drar nytta av sökning”. I praktiken handlar det om en teknik där AI:n inte svarar enbart utifrån sitt minne eller sina träningsdata, utan först söker information från en definierad källa och formar svaret utifrån den.
Google Cloud beskriver RAG som ett AI-ramverk som kombinerar traditionell informationssökning, såsom söksystem och databaser, med generativa språkmodellers förmåga att producera naturligt språk. Målet är att göra svaren mer exakta, mer aktuella och bättre anpassade till användarens eget behov.[1]
Enklare uttryckt: RAG ger AI:n ett bibliotekskort. I stället för att modellen försöker svara enbart ur minnet får den möjlighet att kontrollera relevant information innan den svarar.
2. Vad betyder RAG?
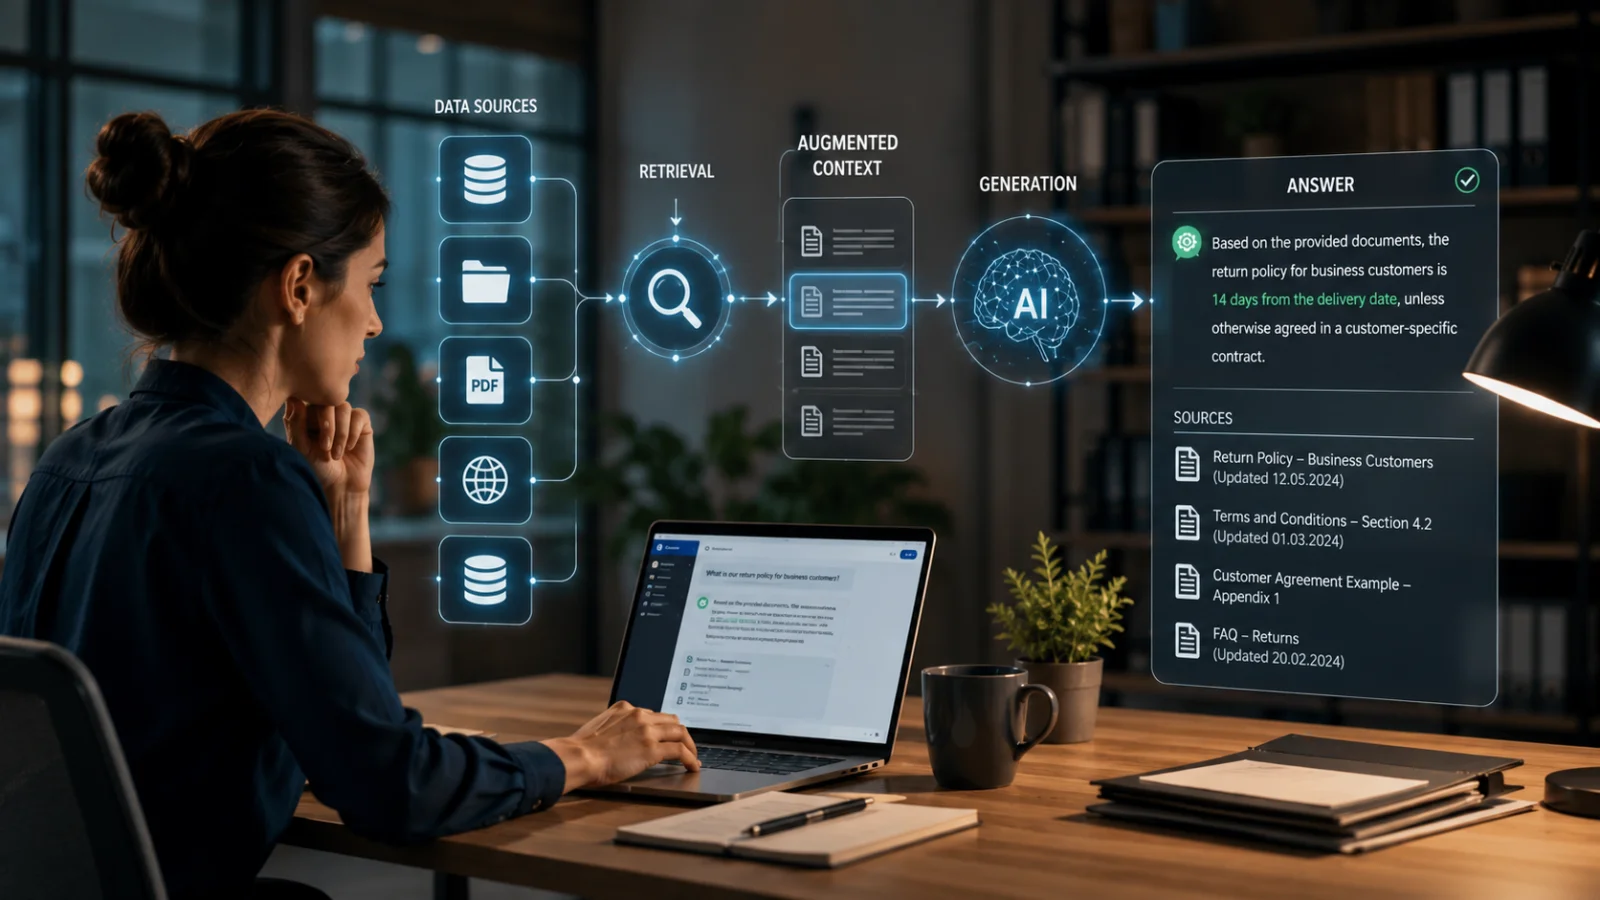
RAG kommer från orden Retrieval-Augmented Generation. Det består av tre idéer:
Retrieval — informationssökning
Systemet söker efter information som är relevant för användarens fråga i en extern källa. Källan kan till exempel vara:
- företagets interna kunskapsbank
- produktdokumentation
- kundsupportanvisningar
- intranät
- avtalsmallar
- forskningsrapporter
- webbsidor
- databas
- PDF-dokument
- CRM- eller ERP-system
- vanliga frågor
- utbildningsmaterial
Augmented — kompletterad
Den hämtade informationen läggs till i AI:ns kontext. Modellen får alltså, utöver användarens fråga, det material som hör till ämnet.
Generation — att producera svaret
Språkmodellen formar ett svar till användaren utifrån den hämtade informationen.
Amazon Web Services definierar RAG som ett sätt att optimera en stor språkmodells output så att den hänvisar till en auktoritativ kunskapsbas utanför träningsdata. Detta hjälper modellen att producera mer exakta och mer användbara svar.[2]
Den viktiga skillnaden jämfört med ett vanligt AI-svar är denna:
Utan RAG svarar modellen utifrån vad den har lärt sig under träningen och vad användaren ger i samtalet. Med RAG får modellen dessutom hämtad, mer exakt och ofta mer aktuell information för just den aktuella frågan.
3. Varför uppstod RAG?
RAG uppstod för att lösa ett av den generativa AI:ns grundproblem: språkmodeller är imponerande, men deras kunskap är inte automatiskt aktuell, kontrollerad eller organisationsspecifik.
En stor språkmodell kan känna till många allmängiltiga saker. Den kan förklara vad kassaflöde är, hur en SaaS-verksamhet fungerar eller varför kundlojalitet är viktig. Men den vet inte nödvändigtvis:
- vad som står i just ditt företags produktanvisningar
- vilken prislista som är den senaste
- vad som beslutades i förra veckans styrelsematerial
- vilken kundsupportpraxis som gäller i dag
- vad organisationens informationssäkerhetspolicy tillåter
- hur en viss avtalsversion skiljer sig från den föregående
- vad den aktuella myndighetsanvisningen säger
IBM Research beskriver RAG som en ”open book”-ansats: modellen svarar inte på ett prov med stängd bok, utan får använda externa källor som stöd för sitt svar. Enligt IBM är RAG:s två centrala fördelar tillgång till aktuella och tillförlitliga fakta samt att användaren kan se vilka källor svaret bygger på.[3]
Detta är en stor förändring. En traditionell språkmodell är som en smart generalist som minns mycket men kan blanda ihop detaljer. En RAG-modell är som samma expert med rätt dokument framför sig.
4. Hur fungerar RAG i praktiken?
Ett RAG-systems funktion kan beskrivas i fem steg.
1. Informationen samlas in
Först förs material in i systemet. Det kan till exempel vara:
- företagets dokument
- innehåll från webbsidor
- anvisningar
- artiklar i kunskapsbasen
- produktbeskrivningar
- svar från kundsupporten
- interna processbeskrivningar
Detta steg kallas ofta datainmatning (data ingestion), det vill säga att föra in informationen i systemet.
2. Informationen delas upp i delar
Långa dokument delas in i mindre delar som ofta kallas chunkar. En chunk är en lagom stor textbit, till exempel några stycken eller en del av en sida.
Detta är viktigt, eftersom det vanligtvis inte lönar sig för AI:n att läsa hela dokumentbiblioteket för varje fråga. Den behöver hitta just de rätta ställena.
3. Informationen indexeras
Dokumentdelarna omvandlas till ett format där de kan sökas effektivt. Ofta används så kallade embeddingar. En embedding är en numerisk representation av text: systemet omvandlar texten till ett matematiskt ”fingeravtryck” som gör det möjligt att hitta liknande innehåll.
Dessa lagras ofta i en vektordatabas. Det är en databas som är utformad för att hitta innehåll som liknar varandra i betydelse, inte bara exakt samma ord.
4. Relevant material hämtas till användarens fråga
När användaren frågar något söker systemet i databasen efter de textbitar som hör till frågan. Om frågan är:
”Hur fungerar vårt företags returpraxis för företagskunder?”
kan RAG-systemet hämta returvillkoren, kundtjänstanvisningen och en eventuell avtalsbilaga.
5. Språkmodellen formar ett svar utifrån källorna
Till sist får språkmodellen användarens fråga och de hämtade textbitarna. Dess uppgift är att forma ett tydligt svar utifrån dem.
I Google Clouds beskrivning av Vertex AI RAG Engine följer processen samma logik: data förs in i systemet, omvandlas och delas upp, indexeras, hämtas i relation till användarens fråga och ges till modellen som kontext. Google betonar att den extra kontexten hjälper modellen att svara mer exakt och att minska hallucinationer.[4]
5. RAG med en enkel liknelse
Tänk dig två experter.
Den första experten sitter i ett mötesrum utan material. Hen har läst mycket och kan tala övertygande. När hen får en fråga svarar hen utifrån minnet. Ofta är svaret bra. Men om man frågar om den senaste prislistan, en exakt punkt i avtalsvillkoren eller det här veckans beslut kan hen ta fel.
Den andra experten sitter i samma rum, men har tillgång till företagets dokument, färska anvisningar och ett söksystem. När hen får en fråga letar hen först upp rätt ställe och svarar utifrån det.
Detta är idén med RAG. Det gör inte AI:n ofelbar. Men det ger den ett bättre skrivbord.
NVIDIA jämför RAG med ett biträde i en rättssal: en stor språkmodell kan vara som en domare med allmän förståelse, men för ett visst fall behövs handlingar, prejudikat och källor. RAG fungerar som en ”bibliotekarie” som hämtar det material modellen behöver.[5]
Liknelsen är träffande eftersom den avslöjar kärnan i RAG: ett bra svar uppstår inte enbart ur intelligens. Det uppstår ur rätt information vid rätt tillfälle.
6. Hur minskar RAG hallucinationer?
En hallucination är en situation där AI:n producerar trovärdigt klingande men felaktig eller påhittad information. RAG minskar hallucinationer eftersom det förankrar svaret i det hämtade materialet.
Utan RAG kan AI:n svara så här:
”Er returtid är 30 dagar.”
Med RAG kan svaret bygga på ett dokument:
”För företagskunder är returtiden enligt avtalsvillkoren 14 dagar, om inget annat har avtalats i det kundspecifika avtalet.”
Skillnaden är enorm. RAG hjälper särskilt på tre sätt.
1. Modellen får en faktabas
När modellen får ett relevant dokument behöver den inte hitta på ett svar ur tomma intet.
2. Svaret kan källhänvisas
Ett bra RAG-system visar vilket dokument eller vilken punkt svaret bygger på.
3. Användaren kan kontrollera påståendena
Källorna gör svaret mer granskningsbart. Användaren kan öppna originaldokumentet och se om svaret stämmer.
Microsoft lyfter fram minskade hallucinationer och källornas transparens som fördelar med RAG. Enligt Microsoft kan RAG öka förtroendet särskilt inom högriskbranscher som juridik, hälso- och sjukvård och finans, eftersom användaren kan kontrollera vad påståendena bygger på.↗[6]
Men en viktig anmärkning: RAG eliminerar inte hallucinationer helt. Det minskar risken, om sökningen hittar rätt information och modellen använder den korrekt.
7. Varför håller RAG svaren mer aktuella?
En stor språkmodell har tränats på ett visst material fram till en viss tidpunkt. Dess interna kunskap kan bli föråldrad. RAG löser det här problemet genom att koppla modellen till externa informationskällor som kan uppdateras utan att hela modellen tränas om.
Detta är en enorm fördel för företag.
Om prislistan ändras behöver man inte träna en ny språkmodell — man uppdaterar prislistedokumentet eller databasen. Om en kundsupportanvisning ändras uppdaterar man anvisningen. Om lagstiftningen ändras uppdaterar man källmaterialet.
IBM lyfter fram tillgång till aktuella och branschspecifika data samt att organisationer kan förbättra AI:ns svar utan kostsam omträning av modellen som fördelar med RAG.[7]
Här syns RAG:s praktiska styrka. AI:n är inte längre bara en modell som ”vet vad den vet”. Den blir ett gränssnitt till en levande kunskapsbas.
8. RAG i företag och organisationer
I företag är RAG ett av de viktigaste sätten att göra generativ AI verkligt användbar. Varför? Eftersom företagens värde vanligtvis inte bara ligger i allmän kunskap. Det ligger i den egna datan, de egna processerna, de egna kunderna och de egna dokumenten.
RAG kan hjälpa till exempel i följande användningsfall:
Kundtjänst
En chatbot kan svara på kundens frågor utifrån företagets egna anvisningar, avtalsvillkor och produktinformation.
Försäljning
En säljare kan fråga AI:n:
”Vad är värt att tänka på om den här kunden inför mötet?”
RAG kan hämta CRM-anteckningar, tidigare offerter, supportärenden och information om kundsegmentet.
HR
En medarbetare kan fråga:
”Hur fungerar föräldraledigheten på vårt företag?”
RAG kan hämta svaret ur personalhandboken och eventuella lokala rutiner.
Juridik och compliance
En jurist eller ett compliance-team kan hämta avtalspunkter, regelverksanvisningar och interna policyer.
Produktutveckling
Produktteamet kan analysera kundfeedback, supportärenden och roadmap-dokument.
Utbildning
En ny medarbetare kan fråga om organisationens arbetssätt och få svar utifrån introduktionsmaterialet.
Amazon Web Services beskriver RAG som ett pragmatiskt och effektivt sätt att använda språkmodeller i företag, eftersom det ger modellen externa data, såsom företagets interna dokument, med vars hjälp svaren passar bättre för ett visst användningsfall.[8]
Här ligger RAG:s affärsmässiga kärna: det förvandlar AI:n från en allmän skribent till ett gränssnitt för organisationens kunskapsarbete.
9. RAG i AI-assistenter: vad bör användaren förstå?
Det praktiska tipset lyder:
En RAG-baserad AI-assistent grundar sina svar på aktuell information.
För användaren är detta ett viktigt löfte, men det behöver förstås rätt. RAG innebär att AI-assistenten kan hämta information ur definierade källor innan den formulerar sitt svar. Användaren får då inte bara en gissning från en generell språkmodell, utan ett svar som bygger på den kunskapsbas som systemet har tillgång till.
I praktiken kan det till exempel innebära att en RAG-baserad AI-assistent:
- hämtar information ur organisationens egna dokument
- använder aktuella anvisningar
- hänvisar till källmaterialet
- minskar risken för påhittade svar
- kan svara på organisationsspecifika frågor
- hjälper användaren att hitta rätt information snabbare
Det är dock viktigt att säga ärligt: RAG gör inget AI-system automatiskt perfekt. I en RAG-lösning beror slutresultatets kvalitet bland annat på:
- hur högkvalitativ kunskapsbasen är
- hur aktuella källorna är
- om sökningen hittar rätt dokument
- om modellen kan använda den hämtade informationen korrekt
- om källorna visas för användaren
- hur man agerar i osäkra situationer
Ett bra RAG-system svarar inte bara. Det hjälper användaren att se vad svaret bygger på.
Därför är det värt att be om följande när man använder en RAG-baserad AI-assistent:
”Visa vilken källa det här svaret bygger på.”
Eller:
”Om svaret inte finns i källmaterialet, säg det rakt ut.”
Detta gör användningen av AI:n säkrare och mer transparent.
10. RAG:s fördelar: varför pratar man så mycket om det här?
RAG har snabbt blivit en av den generativa AI:ns viktigaste tekniker, eftersom det direkt adresserar AI:ns praktiska smärtpunkter.
10.1 Färre hallucinationer
När svaret bygger på hämtat material gissar modellen mindre.
10.2 Mer aktuell information
Kunskapsbasen kan uppdateras utan att modellen tränas om.
10.3 Organisationsspecifik kompetens
RAG kan dra nytta av företagets egna data, som en allmän språkmodell inte känner till.
10.4 Bättre transparens
Källhänvisningar och dokumentlänkar hjälper användaren att kontrollera svaret.
10.5 Kostnadseffektivitet
RAG kan vara ett lättare alternativ än ständig finjustering eller omträning av modellen.
10.6 Snabbare att hitta information
Användaren behöver inte leta reda på rätt PDF, intranätsida eller anvisning för hand.
10.7 Bättre kundupplevelse
En kundtjänstbot kan ge mer exakta svar om den bygger på företagets rätta anvisningar.
Google Cloud beskriver att RAG kombinerar organisationens egna data med språkmodellernas språkliga förmågor, varvid svaren kan bli mer exakta, mer aktuella och mer relevanta för användarens behov.[1]
I den meningen är RAG lite som en verklighetskontroll för AI:n. Det producerar inte bara text — det hämtar först den mark som texten byggs på.
11. RAG:s begränsningar: varför är det ingen mirakellösning?
RAG är effektivt, men inte magiskt. Det kan misslyckas på många sätt.
11.1 Sökningen kan hitta fel information
Om systemet hämtar fel dokument eller fel ställe kan svaret bli fel. Detta är RAG:s klassiska problem: genereringen kan vara bra, men retrieval, alltså sökningen, misslyckas.
11.2 Informationen kan vara föråldrad
RAG håller svaren aktuella bara om kunskapsbasen är aktuell. Om det finns en gammal anvisning i databasen kan AI:n svara enligt den gamla anvisningen.
11.3 Dokumenten kan vara motstridiga
Om det i organisationen finns tre olika versioner av samma anvisning kan RAG hämta fel version eller blanda ihop dem.
11.4 Modellen kan tolka källan fel
Även om rätt dokument hittas kan språkmodellen missförstå det eller generalisera för mycket.
11.5 Källan kanske inte räcker för att svara
Om den hämtade kontexten inte innehåller tillräcklig information borde modellen säga ”jag vet inte”. Alla system gör inte detta bra.
Google Research har lyft fram begreppet sufficient context, det vill säga tillräcklig kontext. Enligt dem räcker det inte i RAG-system att den hämtade informationen på något sätt är relevant. Den måste vara tillräcklig för att frågan ska kunna besvaras korrekt. Om kontexten inte räcker borde modellen hellre känna igen osäkerheten än hitta på ett svar.[9]
Detta är en viktig insikt. RAG är inte bara en sökmotor plus AI. Det är en kvalitetsfråga: hittas just den information som räcker till ett korrekt svar?
11.6 RAG kan ge en falsk känsla av trygghet
När ett svar har källhänvisningar ser det tillförlitligt ut. Men en källhänvisning betyder inte automatiskt att svaret är korrekt. Källan kan vara fel, gammal eller feltolkad. Därför måste användaren fortfarande kontrollera kritiska påståenden.
12. Hur bygger man ett bra RAG-system?
Ett bra RAG-system uppstår inte bara genom att koppla ihop en språkmodell och en dokumentmapp. Det kräver noggrann planering.
12.1 En högkvalitativ kunskapsbas
Den första frågan är: vilken information matas in i systemet? Om kunskapsbasen är rörig, gammal eller motstridig blir svaren också lidande. En bra kunskapsbas är:
- aktuell
- kurerad
- tydligt strukturerad
- versionshanterad
- underhållen av ansvariga personer
- med hanterade åtkomsträttigheter
12.2 Bra uppdelning av dokument
Om dokumenten delas upp för smått försvinner kontexten. Om de delas upp för stort kan sökningen bli oprecis. Chunking är ett förvånansvärt viktigt tekniskt val. Det påverkar om systemet hittar rätt ställe.
12.3 En fungerande sökmetod
Enbart nyckelordssökning räcker inte alltid. Vektorsökning hittar innehåll som liknar varandra i betydelse, även om orden inte är exakt desamma. Ofta är den bästa lösningen en hybridsökning som kombinerar nyckelordssökning och semantisk sökning.
12.4 Att visa källorna
Användaren måste kunna se vad svaret bygger på. Ett bra RAG-svar kan innehålla:
- dokumentets namn
- avsnittet eller sidan
- en länk till källan
- en kort motivering
- osäkerheten, om källan inte räcker
12.5 Tydliga instruktioner till modellen
Modellen måste få veta hur den ska agera. Till exempel:
”Svara endast utifrån de angivna källorna. Om källorna inte innehåller svaret, säg det rakt ut.”
Detta minskar gissandet.
12.6 Utvärdering och testning
Ett RAG-system måste testas med riktiga frågor. Amazon Web Services betonar utvärderingen av RAG-applikationers tillförlitlighet: systemet bör mätas bland annat med avseende på prestanda, tillförlitlighet och eventuella skevheter.[10]
Vid testningen är det värt att fråga:
- Hittas rätt källa?
- Bygger svaret på källan?
- Avstår modellen från att svara om informationen saknas?
- Syns källorna för användaren?
- Är svaret för säkert?
- Fungerar systemet för olika användargrupper?
Ett bra RAG är en kontinuerlig process, inte ett engångsprojekt.
13. RAG vs. finjustering: när behövs vilket?
RAG förväxlas ofta med finjustering av modellen. Det är olika saker.
RAG
RAG ger modellen extern information i svarsögonblicket. Det passar när:
- informationen ändras ofta
- man vill använda organisationens dokument
- källorna måste visas
- svaren måste hållas aktuella
- man vill undvika omträning av modellen
Finjustering
Finjustering innebär att modellen tränas ytterligare på ett visst material eller för en viss uppgift. Det passar när:
- man vill ändra modellens stil
- man vill lära in ett visst svarsformat
- man vill förbättra prestandan i en avgränsad uppgift
- datan är relativt beständig
- det behövs ett särskilt beteende, inte bara ny information
Ofta är den bästa lösningen inte antingen–eller. Ett företag kan använda RAG för aktuell information och finjustering till exempel för att lära in en viss svarsstil eller process.
Men om problemet är ”modellen känner inte till våra senaste anvisningar” är RAG oftast en mer naturlig lösning än finjustering.
14. Framtiden: från RAG mot agenter och intelligenta system för kunskapsarbete
RAG är redan viktigt, men dess betydelse växer när AI:n går från enbart chatbotar mot agenter.
En agent är ett AI-system som inte bara svarar på en fråga, utan kan utföra flera steg: hämta information, jämföra alternativ, använda verktyg, forma en plan och kanske till och med utföra uppgifter.
RAG är grundläggande infrastruktur för sådana agenter. Om en agent ska hjälpa en medarbetare måste den veta:
- vad som står i organisationens anvisningar
- vad kunden har gjort tidigare
- vad som händer i systemen
- vilka regler som måste följas
- vilka dokument som får användas
- vad informationen bygger på
IBM beskriver ansatsen agentic RAG, där ett RAG-system kombineras med agentliknande förmågor: systemet kan hämta information från en extern kunskapsbas och använda den för att producera mer exakta, branschspecifika svar utan att modellen enbart lutar sig mot sina träningsdata.[11]
I framtiden syns RAG kanske inte för användaren som en separat teknik. Det syns som bättre svar.
Användaren frågar, och systemet:
- hämtar rätt källor
- bedömer om de räcker
- formar svaret
- visar källorna
- anger osäkerheten
- föreslår nästa åtgärd
Detta är ett stort steg mot en AI som inte bara låter smart, utan fungerar mer tillförlitligt som en del av det dagliga arbetet.
15. Slutsatser: vad är värt att lära sig av detta?
RAG är en av de viktigaste teknikerna när generativ AI förs in i det verkliga arbetslivet. Det löser tre stora problem:
- AI:ns kunskap kan vara föråldrad
- AI:n känner inte till organisationens egna data
- AI:n kan hallucinera övertygande
RAG gör inte AI:n perfekt. Men det gör den mer användbar, mer kontrollerbar och bättre förankrad i verklig kunskap.
De viktigaste lärdomarna är dessa:
1. RAG innebär att AI:n först hämtar information och svarar först därefter
Detta skiljer det från ett vanligt språkmodellsvar.
2. RAG minskar hallucinationer, men eliminerar dem inte helt
En felaktig sökning, en gammal källa eller en dålig tolkning kan ändå leda till ett fel.
3. Källorna är RAG:s stora styrka
När ett svar kan spåras till ett dokument kan användaren kontrollera det.
4. Aktualiteten beror på kunskapsbasen
RAG är bara så bra som de data det använder.
5. I företag är RAG nyckeln till att dra nytta av intern kunskap
Det kan förvandla intranätet, dokumentmappen och anvisningsbanken till ett samtalande gränssnitt.
6. Med en RAG-baserad AI-assistent är det värt att be att få se källorna
Användaren bör fråga: ”Vad bygger det här svaret på?”
7. Det bästa RAG säger ibland: ”Jag vet inte”
Ett tillförlitligt system hittar inte på ett svar om källorna inte räcker.
Kärnan i RAG är i slutändan enkel: AI:n blir bättre när den inte tvingas svara ensam.
När modellen får rätt information, rätt källor och rätt kontext som stöd kan den hjälpa mycket mer än en enbart allmän chatbot. Den är inte längre bara en textmaskin. Den är en informationssökare, en uttolkare och en arbetspartner — så länge människan fortfarande kommer ihåg att fråga, kontrollera och använda sitt eget omdöme.
16. Praktiska prompter för användning av ett RAG-system
Här är promptmallar som du kan använda med vilken RAG-baserad AI-lösning som helst.
16.1 Källbaserat svar
Svara endast utifrån de tillgängliga källorna.
Om svaret inte finns i källorna, säg: ”Jag hittar inget svar på detta i det tillgängliga materialet.”
Lägg till källorna eller dokumenten som svaret bygger på i slutet av svaret.
16.2 Att identifiera osäkerhet
Svara på frågan utifrån källorna. Skilj i svaret på:
1) vad källorna säger med säkerhet
2) vad som kan härledas
3) vad som inte kan härledas ur det givna materialet
16.3 Jämförelse av dokument
Jämför dessa källor med varandra.
Leta efter motsägelser, överlappningar och ställen där ett nyare dokument verkar ersätta ett äldre.
Dra inga slutsatser som källorna inte stöder.
16.4 Kundtjänstsvar
Utforma ett tydligt svar till kunden utifrån källmaterialet.
Håll tonen vänlig och professionell.
Lova inget som inte står i källorna.
Om ärendet kräver en mänsklig kontroll, säg det tydligt.
16.5 Stöd för beslutsfattande
Gör en kortfattad analys av detta ämne utifrån källmaterialet. Ge:
• de viktigaste fakta
• möjliga risker
• öppna frågor
• vad som bör kontrolleras innan beslut fattasLägg inte till extern information utan särskild markering.
16.6 Kontroll av ett RAG-svar
Kontrollera ditt föregående svar.
Markera varje centralt påstående enligt källan.
Om ett påstående inte bygger på en källa, ta bort det eller markera det som ett antagande.
Praktisk sammanfattning
Om prompt engineering lär oss att fråga AI:n bättre, lär RAG AI:n att svara utifrån bättre källor. Det är en avgörande skillnad.
En vanlig AI kan låta rätt. En RAG-baserad AI kan visa vad svaret bygger på. Och just det gör den till en så viktig teknik för företag, experter och alla som vill använda AI till mer än bara idégenerering.
Praktiskt tips: när du använder en RAG-baserad AI-assistent, be den att visa källorna och att säga till om svaret inte finns i materialet. Det är ett litet sätt att bygga ett större förtroende för användningen av AI.
Källor
- What is Retrieval-Augmented Generation (RAG)? — Google Cloud
- What is RAG? Retrieval-Augmented Generation AI — Amazon Web Services
- What is retrieval-augmented generation (RAG)? — IBM Research
- Vertex AI RAG Engine overview — Google Cloud Documentation
- What Is Retrieval-Augmented Generation aka RAG — NVIDIA Blog
- 5 key features and benefits of retrieval augmented generation — Microsoft
- O que é RAG (retrieval-augmented generation)? — IBM
- Understanding Retrieval Augmented Generation — AWS Prescriptive Guidance
- Deeper insights into retrieval augmented generation — Google Research
- Evaluate the reliability of RAG applications — AWS Machine Learning Blog
- What is Agentic RAG? — IBM