
1. Innledning: hvorfor er ikke AI alene alltid nok?
AI kan skrive forbausende flytende.
Den kan forklare et komplisert begrep, oppsummere en rapport, skissere en kundemelding eller gi oversikt over en strategi. Samtidig har mange blitt kjent med den største svakheten: Modellen kan svare selvsikkert selv når den mangler nødvendig kunnskap. Den kan høres ut som en ekspert selv når den gjetter.
Dette er et særlig stort problem i arbeidslivet. Bedrifter vil vanligvis ikke bare ha velformulert tekst fra AI. De trenger svar som bygger på riktige dokumenter, oppdatert kunnskap, interne retningslinjer, kundedata eller pålitelige kilder.
RAG, eller Retrieval-Augmented Generation, ble utviklet for å dekke dette behovet.
På norsk kan uttrykket litt tungvint oversettes med «søkeutvidet generering». I praksis betyr det at AI ikke svarer bare ut fra hukommelsen eller treningsdataene sine. Den henter først informasjon fra en definert kilde og lager svaret på grunnlag av denne informasjonen.
Google Cloud beskriver RAG som et rammeverk for AI som kombinerer tradisjonelt informasjonssøk, for eksempel søkesystemer og databaser, med generative språkmodellers evne til å produsere naturlig språk. Målet er mer presise og oppdaterte svar som er bedre tilpasset brukerens behov.[1]
Enklere sagt: RAG gir AI et bibliotekkort. I stedet for å svare bare ut fra hukommelsen kan modellen kontrollere relevante opplysninger før den svarer.
2. Hva betyr RAG?
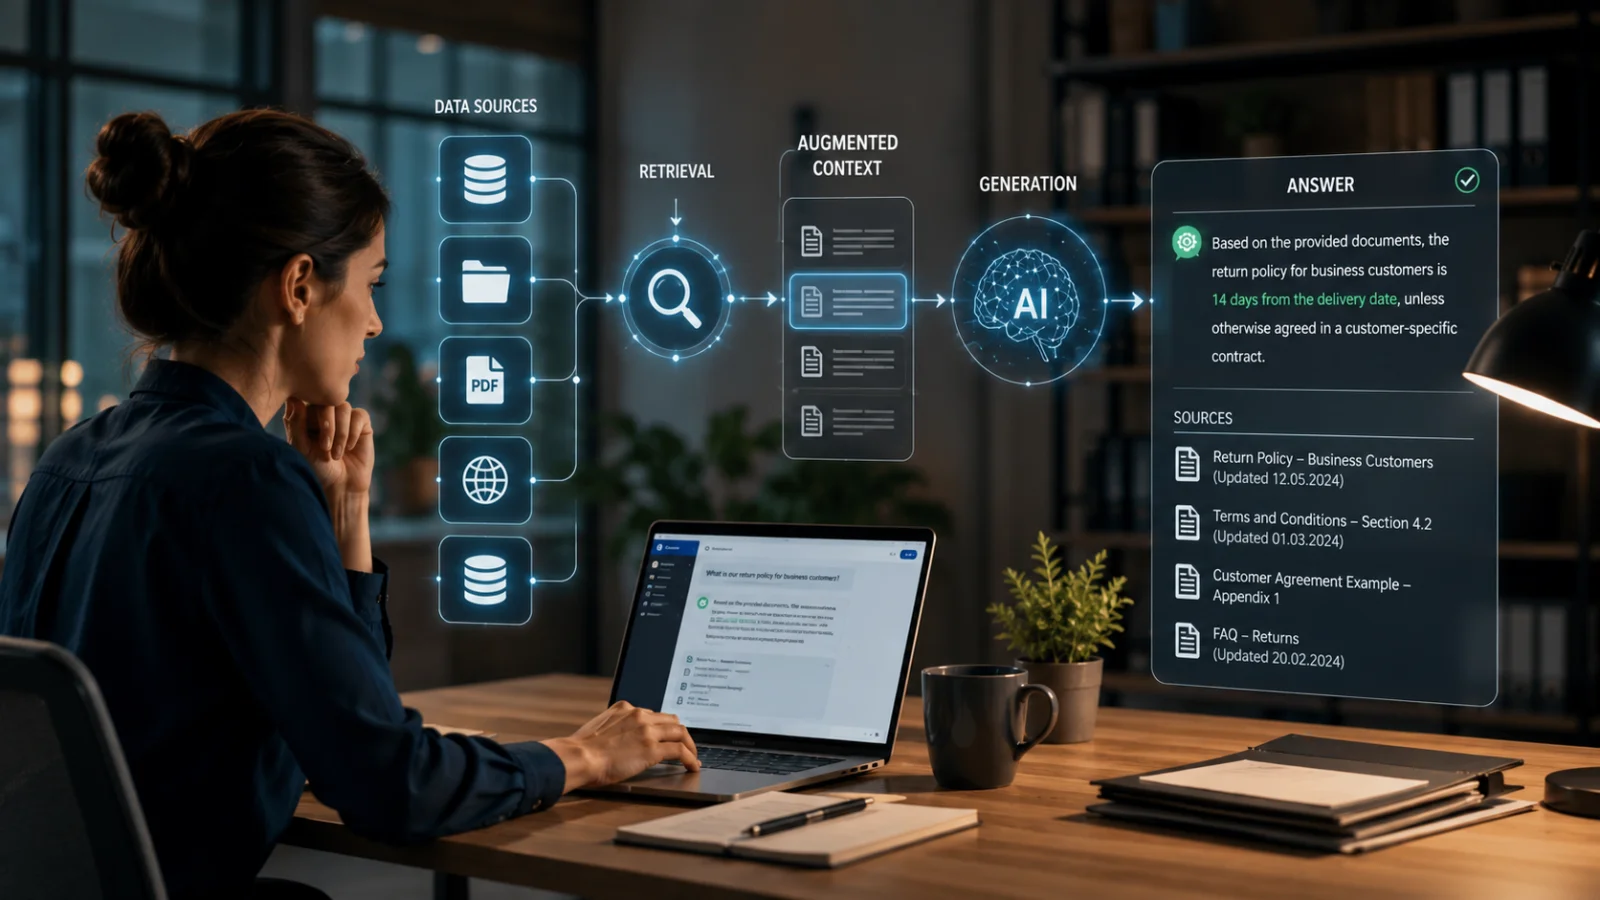
RAG kommer fra ordene Retrieval-Augmented Generation. Det består av tre idéer:
Retrieval — informasjonssøk
Systemet leter i en ekstern kilde etter informasjon som er relevant for brukerens spørsmål. Kilden kan for eksempel være:
- bedriftens interne kunnskapsbase
- produktdokumentasjon
- veiledninger til kundestøtte
- intranett
- avtalemaler
- forskningsrapporter
- websider
- database
- PDF-dokumenter
- CRM- eller ERP-system
- ofte stilte spørsmål
- opplæringsmateriell
Augmented — utvidet
Den innhentede informasjonen legges til AI-ens kontekst. I tillegg til brukerens spørsmål får modellen altså også det relevante materialet.
Generation — generering av svaret
Språkmodellen lager et svar til brukeren på grunnlag av informasjonen som ble hentet.
Amazon Web Services definerer RAG som en metode for å forbedre resultatet fra en stor språkmodell ved å la den bruke et autoritativt kunnskapsgrunnlag utenfor treningsdataene. Det hjelper modellen med å produsere mer presise og nyttige svar.[2]
Dette er den viktige forskjellen fra et vanlig AI-svar:
Uten RAG svarer modellen ut fra det den har lært under treningen og informasjonen brukeren gir i samtalen. Med RAG får modellen i tillegg mer presis og ofte mer oppdatert informasjon som er hentet spesielt for spørsmålet.
3. Hvorfor oppsto RAG?
RAG ble utviklet for å løse et grunnproblem ved generativ AI: Språkmodeller er imponerende, men kunnskapen deres er ikke automatisk oppdatert, kontrollert eller tilpasset en bestemt organisasjon.
En stor språkmodell kan ha mye generell kunnskap. Den kan forklare hva kontantstrøm er, hvordan en SaaS-virksomhet fungerer, eller hvorfor kundelojalitet er viktig. Men den vet ikke nødvendigvis:
- hva som står i produktveiledningene til akkurat din bedrift
- hva som er den nyeste prislisten
- hva som ble vedtatt i styrematerialet forrige uke
- hva som er dagens praksis for kundestøtte
- hva organisasjonens informasjonssikkerhetspolicy tillater
- hvordan en bestemt avtaleversjon skiller seg fra den forrige
- hva den oppdaterte veiledningen fra myndighetene sier
IBM Research beskriver RAG som en «open book»-tilnærming: Modellen tar ikke en prøve uten hjelpemidler, men får bruke eksterne kilder som støtte for svaret. Ifølge IBM er to sentrale fordeler tilgang til oppdaterte og pålitelige fakta, og at brukeren kan se hvilke kilder svaret bygger på.[3]
Dette er en stor endring. En tradisjonell språkmodell er som en smart generalist som husker mye, men kan blande sammen detaljer. En RAG-modell er som den samme eksperten med de riktige dokumentene foran seg.
4. Hvordan fungerer RAG i praksis?
Et RAG-systems virkemåte kan beskrives i fem trinn.
1. Informasjonen samles inn
Først legges materiale inn i systemet. Det kan for eksempel være:
- bedriftens dokumenter
- innhold fra websider
- veiledninger
- kunnskapsbaseartikler
- produktbeskrivelser
- svar fra kundestøtte
- interne prosessbeskrivelser
Dette trinnet kalles ofte datainntak, altså at informasjon legges inn i systemet.
2. Informasjonen deles opp i deler
Lange dokumenter deles i mindre deler, ofte kalt tekstblokker eller «chunks». En tekstblokk er et tekstutdrag av passende størrelse, for eksempel noen avsnitt eller en del av en side.
Dette er viktig fordi AI vanligvis ikke bør lese hele dokumentbiblioteket for hvert spørsmål. Systemet må finne akkurat de riktige avsnittene.
3. Informasjonen indekseres
Dokumentbitene omformes til et format som kan gjennomsøkes effektivt. Ofte brukes såkalte embeddings. En embedding er en numerisk representasjon av teksten: Systemet gjør teksten om til et matematisk «fingeravtrykk» som gjør det mulig å finne innhold med lignende betydning.
Disse representasjonene lagres ofte i en vektordatabase. Den er utviklet for å finne innhold med lignende betydning, ikke bare innhold med nøyaktig de samme ordene.
4. Relevant materiale hentes til brukerens spørsmål
Når brukeren stiller et spørsmål, leter systemet i databasen etter relevante tekstbiter. Hvis spørsmålet er:
«Hvordan fungerer bedriftens returpraksis for bedriftskunder?»
kan RAG-systemet hente returvilkårene, kundeserviceveiledningen og et eventuelt avtalevedlegg.
5. Språkmodellen utformer svaret på grunnlag av kildene
Til slutt får språkmodellen brukerens spørsmål og tekstbitene som ble hentet. Oppgaven er å lage et tydelig svar på grunnlag av dem.
Google Cloud beskriver samme prosess for Vertex AI RAG Engine: Data legges inn, omformes, deles opp og indekseres. Deretter hentes data som er relevante for brukerens spørsmål, og gis til modellen som kontekst. Google fremhever at den ekstra konteksten kan gi mer presise svar og færre hallusinasjoner.[4]
5. RAG forklart med en enkel sammenligning
La oss se for oss to eksperter.
Den første eksperten sitter i et møterom uten materiale. Eksperten har lest mye og snakker overbevisende. Når noen spør om noe, svarer eksperten ut fra hukommelsen. Svaret er ofte godt. Men eksperten kan ta feil når spørsmålet gjelder den nyeste prislisten, et nøyaktig punkt i avtalevilkårene eller ukens beslutning.
Den andre eksperten sitter i samme rom, men har tilgang til bedriftens dokumenter, oppdaterte veiledninger og et søkesystem. Eksperten finner først riktig avsnitt og svarer deretter på grunnlag av det.
Det er idéen med RAG. Det gjør ikke AI-en ufeilbarlig. Men det gir den et bedre arbeidsbord.
NVIDIA sammenligner RAG med en assistent i en rettssal: En stor språkmodell kan ligne en dommer med generell forståelse, men en bestemt sak krever dokumenter, rettspraksis og kilder. RAG er «bibliotekaren» som henter materialet modellen trenger.[5]
Sammenligningen treffer godt fordi den viser kjernen i RAG: Et godt svar oppstår ikke bare av intelligens, men av riktig informasjon på riktig tidspunkt.
6. Hvordan reduserer RAG hallusinasjoner?
En hallusinasjon oppstår når AI produserer informasjon som høres troverdig ut, men er feil eller oppdiktet. RAG reduserer hallusinasjoner ved å forankre svaret i materialet som er hentet.
Uten RAG kan AI-en svare slik:
«Bedriftens returfrist er 30 dager.»
Med RAG kan svaret bygge på et dokument:
«Ifølge avtalevilkårene er returfristen for bedriftskunder 14 dager, med mindre noe annet er avtalt i avtalen med den aktuelle kunden.»
Forskjellen er enorm. RAG hjelper særlig på tre måter.
1. Modellen får et faktagrunnlag
Når modellen får et relevant dokument, trenger den ikke å dikte opp et svar fra grunnen av.
2. Svaret kan ha kildehenvisninger
Et godt RAG-system viser hvilket dokument og hvilket avsnitt svaret bygger på.
3. Brukeren kan etterprøve påstandene
Kilder gjør svaret lettere å kontrollere. Brukeren kan åpne originaldokumentet og se om svaret stemmer.
Microsoft fremhever færre hallusinasjoner og større åpenhet om kildene som fordeler ved RAG. Ifølge Microsoft kan dette styrke tilliten, særlig på høyrisikoområder som jus, helse og finans, fordi brukeren kan kontrollere grunnlaget for påstandene.↗[6]
En viktig merknad er likevel at RAG ikke fjerner hallusinasjoner helt. Risikoen blir mindre når søket finner riktig informasjon og modellen bruker den riktig.
7. Hvorfor holder RAG svarene mer oppdaterte?
En stor språkmodell er trent på et bestemt datagrunnlag frem til et bestemt tidspunkt. Den interne kunnskapen kan derfor bli utdatert. RAG løser dette ved å koble modellen til eksterne informasjonskilder som kan oppdateres uten at hele modellen må trenes på nytt.
Det er en enorm fordel for bedrifter.
Hvis prislisten endres, trenger man ikke å trene en ny språkmodell. Det holder å oppdatere prislistedokumentet eller databasen. På samme måte kan veiledningen for kundestøtte eller kildematerialet oppdateres når praksis eller lovverk endres.
IBM fremhever at RAG gir tilgang til oppdaterte og bransjespesifikke data, og at organisasjoner kan forbedre AI-svar uten kostbar ny opplæring av modellen.[7]
Her ser vi den praktiske styrken ved RAG. AI er ikke lenger bare en modell som «vet det den vet», men et grensesnitt mot et levende kunnskapsgrunnlag.
8. RAG i bruk i bedrifter og organisasjoner
I bedrifter er RAG en av de viktigste metodene for å gjøre generativ AI virkelig nyttig. Bedriftenes verdi ligger vanligvis ikke bare i generell kunnskap, men i egne data, prosesser, kunder og dokumenter.
RAG kan for eksempel hjelpe på disse områdene:
Kundeservice
En chatbot kan besvare kundens spørsmål ut fra bedriftens egne veiledninger, avtalevilkår og produktopplysninger.
Salg
En selger kan spørre AI-en:
”Hva bør jeg være oppmerksom på hos denne kunden før møtet?”
RAG kan hente CRM-noter, tidligere tilbud, kundestøttehenvendelser og opplysninger om kundesegmentet.
HR
En medarbeider kan spørre:
«Hvordan fungerer foreldrepermisjon i bedriften vår?»
RAG kan hente svaret fra personalhåndboken og eventuelle lokale retningslinjer.
Juridiske spørsmål og etterlevelse
En jurist eller et compliance-team kan hente kontraktpunkter, veiledninger om regelverk og interne politikker.
Produktutvikling
Et produktteam kan analysere kundefeedback, kundestøttehenvendelser og veikartdokumenter.
Opplæring
En ny medarbeider kan spørre om organisasjonens arbeidsprosesser og få svar ut fra onboarding-materialet.
Amazon Web Services beskriver RAG som en praktisk og effektiv måte å bruke språkmodeller i bedrifter på. Modellen får tilgang til eksterne data, for eksempel bedriftens interne dokumenter, slik at svarene passer bedre til det aktuelle bruksområdet.[8]
Dette er den forretningsmessige kjernen i RAG: AI går fra å være en generell tekstforfatter til å bli et grensesnitt mot organisasjonens kunnskap.
9. RAG i AI-assistenter: hva bør brukeren forstå?
Det praktiske tipset er:
En RAG-basert AI-assistent bygger svarene sine på oppdatert informasjon.
For brukeren er dette et viktig løfte, men det må forstås riktig. RAG betyr at AI-assistenten kan hente informasjon fra definerte kilder før den formulerer svaret. Dermed får brukeren ikke bare en gjetning fra en generell språkmodell, men et svar som bygger på kunnskapsgrunnlaget systemet har tilgang til.
I praksis kan det for eksempel bety at en RAG-basert AI-assistent:
- henter informasjon fra organisasjonens egne dokumenter
- bruker oppdaterte veiledninger
- henviser til kildematerialet
- reduserer risikoen for oppdiktede svar
- kan besvare organisasjonsspesifikke spørsmål
- hjelper brukeren med å finne riktig informasjon raskere
Det er likevel viktig å være tydelig: RAG gjør ikke automatisk et AI-system perfekt. I en RAG-løsning avhenger kvaliteten blant annet av:
- hvor høy kvalitet kunnskapsgrunnlaget har
- hvor oppdaterte kildene er
- om søket finner de riktige dokumentene
- om modellen klarer å bruke informasjonen som ble hentet, på riktig måte
- om kildene vises for brukeren
- hvordan systemet håndterer usikre situasjoner
Et godt RAG-system gir ikke bare et svar. Det hjelper også brukeren med å se hva svaret bygger på.
Derfor lønner det seg å be om dette når du bruker en RAG-basert AI-assistent:
«Vis hvilken kilde dette svaret bygger på.»
Eller:
«Hvis svaret ikke finnes i kildematerialet, si det direkte.»
Det gjør bruken av AI mer sikker og mer gjennomsiktig.
10. Fordelene ved RAG: hvorfor snakkes det så mye om det?
RAG har raskt blitt en av de viktigste teknikkene innen generativ AI fordi den retter seg direkte mot praktiske svakheter ved AI.
10.1 Færre hallusinasjoner
Når svaret bygger på materiale som er hentet, trenger modellen å gjette mindre.
10.2 Mer oppdatert informasjon
Kunnskapsgrunnlaget kan oppdateres uten at modellen trenes på nytt.
10.3 Organisasjonsspesifikk kunnskap
RAG kan bruke bedriftens egne data, som en generell språkmodell ikke kjenner.
10.4 Bedre åpenhet
Kildehenvisninger og dokumentlenker hjelper brukeren med å kontrollere svaret.
10.5 Kostnadseffektivitet
RAG kan være et enklere alternativ enn kontinuerlig finjustering eller ny opplæring av modellen.
10.6 Raskere tilgang til informasjon
Brukeren trenger ikke selv å lete etter riktig PDF-fil, intranettside eller veiledning.
10.7 Bedre kundeopplevelse
En kundestøttebot kan gi mer presise svar når den bygger på bedriftens gjeldende veiledninger.
Google Cloud beskriver hvordan RAG kombinerer organisasjonens egne data med språkmodellenes språklige evner. Svarene kan dermed bli mer presise, oppdaterte og relevante for brukerens behov.[1]
RAG fungerer på denne måten litt som en realitetssjekk for AI. Modellen produserer ikke bare tekst, men henter først grunnlaget som teksten skal bygge på.
11. RAGs begrensninger: hvorfor er det ikke en mirakelløsning?
RAG er effektiv, men ikke magisk. Den kan feile på mange måter.
11.1 Søket kan finne feil informasjon
Hvis systemet henter feil dokument eller avsnitt, kan svaret bli feil. Dette er et klassisk RAG-problem: Genereringen kan være god selv om «retrieval», altså søket, svikter.
11.2 Informasjonen kan være utdatert
RAG holder bare svarene oppdaterte når kunnskapsgrunnlaget er oppdatert. Hvis databasen inneholder en gammel veiledning, kan AI svare i tråd med den.
11.3 Dokumentene kan være motstridende
Hvis organisasjonen har tre ulike versjoner av samme veiledning, kan RAG hente feil versjon eller blande dem sammen.
11.4 Modellen kan tolke kilden feil
Selv om systemet finner riktig dokument, kan språkmodellen misforstå det eller generalisere for mye.
11.5 Kilden er kanskje ikke tilstrekkelig til å svare
Hvis konteksten som ble hentet, ikke inneholder nok informasjon, bør modellen si «det vet jeg ikke». Ikke alle systemer gjør dette godt.
Google Research bruker begrepet «sufficient context», altså tilstrekkelig kontekst. I et RAG-system er det ikke nok at informasjonen som hentes, er relevant på en eller annen måte. Den må være tilstrekkelig til å besvare spørsmålet riktig. Hvis konteksten ikke er tilstrekkelig, bør modellen uttrykke usikkerhet i stedet for å dikte opp et svar.[9]
Dette er en viktig innsikt. RAG er ikke bare en søkemotor pluss AI. Det er også et kvalitetsspørsmål: Finner systemet akkurat den informasjonen som trengs for å gi et riktig svar?
11.6 RAG kan gi en falsk følelse av sikkerhet
Et svar med kildehenvisninger ser pålitelig ut. Henvisningen betyr likevel ikke automatisk at svaret er riktig. Kilden kan være feil, gammel eller feiltolket. Brukeren må derfor fortsatt kontrollere kritiske påstander.
12. Hvordan bygger man et godt RAG-system?
Et godt RAG-system oppstår ikke bare ved å koble en språkmodell sammen med en dokumentmappe. Det krever grundig planlegging.
12.1 Et kunnskapsgrunnlag av høy kvalitet
Det første spørsmålet er hvilken informasjon systemet skal få. Hvis kunnskapsgrunnlaget er uoversiktlig, gammelt eller motstridende, blir også svarene dårligere. Et godt kunnskapsgrunnlag er:
- oppdatert
- kurert
- tydelig strukturert
- versjonsstyrt
- vedlikeholdt av ansvarlige personer
- tilgangsstyrt
12.2 God oppdeling av dokumenter
Hvis dokumentene deles i for små biter, forsvinner konteksten. Hvis bitene er for store, kan søket bli upresist. «Chunking», altså oppdeling, er et overraskende viktig teknisk valg fordi det påvirker om systemet finner riktig avsnitt.
12.3 En god søkemetode
Et rent nøkkelordsøk er ikke alltid nok. Vektorsøk kan finne innhold med lignende betydning selv om ordene ikke er de samme. Ofte er et hybridsøk som kombinerer nøkkelordsøk og semantisk søk, den beste løsningen.
12.4 Visning av kildene
Brukeren må kunne se hva svaret bygger på. Et godt RAG-svar kan inneholde:
- dokumentets navn
- avsnittet eller siden
- en lenke til kilden
- en kort begrunnelse
- en tydelig markering av usikkerhet når kilden ikke er tilstrekkelig
12.5 Klare instruksjoner til modellen
Modellen må få tydelige instrukser om hvordan den skal opptre. For eksempel:
«Svar bare på grunnlag av de oppgitte kildene. Hvis kildene ikke inneholder svaret, si det direkte.»
Det reduserer gjettingen.
12.6 Evaluering og test
Et RAG-system må testes med reelle spørsmål. Amazon Web Services fremhever at påliteligheten til RAG-applikasjoner bør vurderes blant annet ut fra ytelse, driftssikkerhet og mulige skjevheter.[10]
Under testen bør man spørre:
- Blir riktig kilde funnet?
- Bygger svaret på kilden?
- Lar modellen være å svare når informasjonen mangler?
- Vises kildene for brukeren?
- Er svaret for bastant?
- Fungerer systemet for ulike brukergrupper?
God RAG er en kontinuerlig prosess, ikke et engangsprosjekt.
13. RAG vs. finjustering: når trenger man hva?
RAG forveksles ofte med finjustering av modellen. Det er to ulike ting.
RAG
RAG gir modellen ekstern informasjon når svaret skal lages. Det passer når:
- informasjonen endrer seg ofte
- man ønsker å bruke organisasjonens dokumenter
- kildene skal vises
- svarene skal holdes oppdaterte
- man ønsker å unngå ny opplæring av modellen
Finjustering
Finjustering betyr at modellen trenes videre på et bestemt datagrunnlag eller for en bestemt oppgave. Det passer når:
- man ønsker å endre modellens stil
- man ønsker å lære den et bestemt svarformat
- man ønsker å forbedre ytelsen i en avgrenset oppgave
- dataene er forholdsvis stabile
- det trengs en særlig atferd, ikke bare ny informasjon
Den beste løsningen er ofte ikke enten–eller. En bedrift kan bruke RAG for oppdatert informasjon og finjustering for å lære modellen en bestemt svarstil eller prosess.
Men hvis problemet er «modellen kjenner ikke våre nyeste veiledninger», er RAG vanligvis en mer naturlig løsning enn finjustering.
14. Fremtiden: fra RAG til agenter og intelligente systemer for kunnskapsarbeid
RAG er allerede viktig, og betydningen vokser når AI beveger seg fra enkle chatboter mot agenter.
En agent er et AI-system som ikke bare svarer på et spørsmål, men kan utføre flere trinn: hente informasjon, sammenligne alternativer, bruke verktøy, lage en plan og kanskje også utføre oppgaver.
RAG er grunnleggende infrastruktur for slike agenter. Hvis en agent skal hjelpe en medarbeider, må den vite:
- hva som står i organisasjonens veiledninger
- hva kunden tidligere har gjort
- hva som skjer i systemene
- hvilke regler som skal følges
- hvilke dokumenter som må brukes
- hva informasjonen bygger på
IBM beskriver «agentic RAG», der et RAG-system kombineres med agentegenskaper. Systemet kan hente informasjon fra et eksternt kunnskapsgrunnlag og bruke den til å lage mer presise, bransjespesifikke svar uten å basere seg bare på treningsdataene.[11]
I fremtiden vil RAG kanskje ikke være synlig for brukeren som en egen teknikk. Den vil komme til uttrykk i form av bedre svar.
Brukeren spør, og systemet:
- henter de riktige kildene
- vurderer om kildene er tilstrekkelige
- utformer svaret
- viser kildene
- opplyser om usikkerheten
- foreslår det neste tiltaket
Dette er et stort skritt mot AI som ikke bare høres smart ut, men også fungerer mer pålitelig i det daglige arbeidet.
15. Konklusjoner: hva bør man lære av dette?
RAG er en av de viktigste teknikkene når generativ AI tas i bruk i arbeidslivet. Den løser tre store problemer:
- AI-ens kunnskap kan være utdatert
- AI-en kjenner ikke organisasjonens egne data
- AI-en kan hallusinere overbevisende
RAG gjør ikke AI perfekt. Men teknikken gjør den mer nyttig, lettere å kontrollere og bedre forankret i reell informasjon.
De viktigste lærdommene er disse:
1. RAG betyr at AI-en først henter informasjon og først deretter svarer
Det skiller den fra et vanlig språkmodellsvar.
2. RAG reduserer hallusinasjoner, men fjerner dem ikke helt
Et feil søk, en gammel kilde eller en dårlig tolkning kan fortsatt føre til feil.
3. Kildene er RAGs store styrke
Når svaret kan spores tilbake til et dokument, kan brukeren kontrollere det.
4. Hvor oppdatert systemet er, avhenger av kunnskapsgrunnlaget
RAG er bare så god som dataene den bruker.
5. I bedrifter er RAG nøkkelen til å utnytte den interne kunnskapen
Den kan gjøre intranettet, dokumentmappen og veiledningsbasen om til et samtalebasert grensesnitt.
6. Be en RAG-basert AI-assistent om å vise kildene
Brukeren bør spørre: «Hva bygger dette svaret på?»
7. Den beste RAG-løsningen sier noen ganger: «Det vet jeg ikke»
Et pålitelig system dikter ikke opp et svar når kildene er utilstrekkelige.
Kjernen i RAG er enkel: AI blir bedre når den ikke må svare alene.
Når modellen får riktig informasjon, riktige kilder og riktig kontekst, kan den hjelpe langt mer enn en generell chatbot. Den er ikke lenger bare en tekstmaskin, men en informasjonssøker, tolker og arbeidspartner. Mennesket må likevel fortsette å spørre, kontrollere og bruke eget skjønn.
16. Praktiske prompter for bruk av et RAG-system
Nedenfor finner du promptmaler som kan brukes med enhver RAG-basert AI-løsning.
16.1 Kildebasert svar
Svar bare på grunnlag av de tilgjengelige kildene.
Hvis svaret ikke finnes i kildene, skal du si: «Jeg finner ikke svar på dette i det tilgjengelige materialet.»
Legg kildene eller dokumentene som svaret bygger på, til slutt i svaret.
16.2 Håndtering av usikkerhet
Svar på spørsmålet ut fra kildene. Skill i svaret mellom:
1) hva kildene sier med sikkerhet
2) hva som kan utledes
3) hva som ikke kan utledes av det gitte materialet
16.3 Sammenligning av dokumenter
Sammenlign disse kildene med hverandre.
Finn motsetninger, overlapp og steder der et nyere dokument ser ut til å erstatte et eldre.
Ikke trekk konklusjoner som kildene ikke støtter.
16.4 Kundeservicesvar
Lag et tydelig svar til kunden ut fra kildematerialet.
Hold tonen vennlig og profesjonell.
Ikke lov noe som ikke står i kildene.
Hvis saken krever en menneskelig kontroll, si det tydelig.
16.5 Beslutningsstøtte
Lag en kortfattet analyse av dette temaet ut fra kildematerialet. Oppgi:
• de viktigste faktaene
• mulige risikoer
• åpne spørsmål
• hva som bør sjekkes før beslutningen tasIkke legg til ekstern informasjon uten å merke den tydelig.
16.6 Kontroll av et RAG-svar
Gå gjennom det forrige svaret ditt.
Merk hver sentrale påstand med den tilhørende kilden.
Hvis en påstand ikke bygger på en kilde, skal du fjerne den eller merke den som en antakelse.
Praktisk oppsummering
Hvis prompt engineering lærer oss å stille bedre spørsmål til AI, lærer RAG AI å svare på grunnlag av bedre kilder. Det er en avgjørende forskjell.
Vanlig AI kan høres riktig ut. RAG-basert AI kan vise hva svaret bygger på. Nettopp derfor er RAG viktig for bedrifter, fagfolk og alle som vil bruke AI til mer enn idéutvikling.
Praktisk tips: Når du bruker en RAG-basert AI-assistent, bør du be om å få se kildene og få beskjed hvis svaret ikke finnes i materialet. Det er et lite grep som kan styrke tilliten til AI-bruken.
Kilder
- What is Retrieval-Augmented Generation (RAG)? — Google Cloud
- What is RAG? Retrieval-Augmented Generation AI — Amazon Web Services
- What is retrieval-augmented generation (RAG)? — IBM Research
- Vertex AI RAG Engine overview — Google Cloud Documentation
- What Is Retrieval-Augmented Generation aka RAG — NVIDIA Blog
- 5 key features and benefits of retrieval augmented generation — Microsoft
- O que é RAG (retrieval-augmented generation)? — IBM
- Understanding Retrieval Augmented Generation — AWS Prescriptive Guidance
- Deeper insights into retrieval augmented generation — Google Research
- Evaluate the reliability of RAG applications — AWS Machine Learning Blog
- What is Agentic RAG? — IBM