
1. Uvod: zakaj sama umetna inteligenca ni vedno dovolj?
Umetna inteligenca zna pisati presenetljivo tekoče.
Lahko pojasni zapleten pojem, povzame poročilo, pripravi osnutek sporočila stranki ali pomaga oblikovati strategijo. Toda mnogi že poznajo tudi njeno največjo slabost: samozavestno lahko odgovori tudi takrat, ko nima dovolj informacij. Zveni lahko kot strokovnjak, čeprav v resnici ugiba.
To je še posebej velika težava pri delu. Podjetja od umetne inteligence navadno ne želijo le lepo napisanega besedila, temveč odgovore, ki temeljijo na pravih dokumentih, ažurnih podatkih, notranjih navodilih, podatkih o strankah ali zanesljivih virih.
Kot odgovor na to potrebo je nastal RAG oziroma Retrieval-Augmented Generation.
Izraz bi lahko nekoliko nerodno prevedli kot »generiranje, dopolnjeno z iskanjem«. V praksi gre za tehniko, pri kateri umetna inteligenca ne odgovarja le na podlagi svojega spomina ali učnih podatkov, temveč najprej poišče informacije v določenem viru in nato iz njih oblikuje odgovor.
Google Cloud opisuje RAG kot okvir umetne inteligence, ki tradicionalno iskanje informacij, na primer v iskalnikih in podatkovnih zbirkah, povezuje z zmožnostjo generativnih jezikovnih modelov za tvorjenje naravnega jezika. Cilj so natančnejši, bolj ažurni odgovori, bolje prilagojeni potrebam uporabnika.[1]
Preprosto povedano: RAG umetni inteligenci priskrbi knjižnično izkaznico. Namesto da bi model odgovarjal zgolj po spominu, lahko pred odgovorom preveri ustrezne informacije.
2. Kaj pomeni RAG?
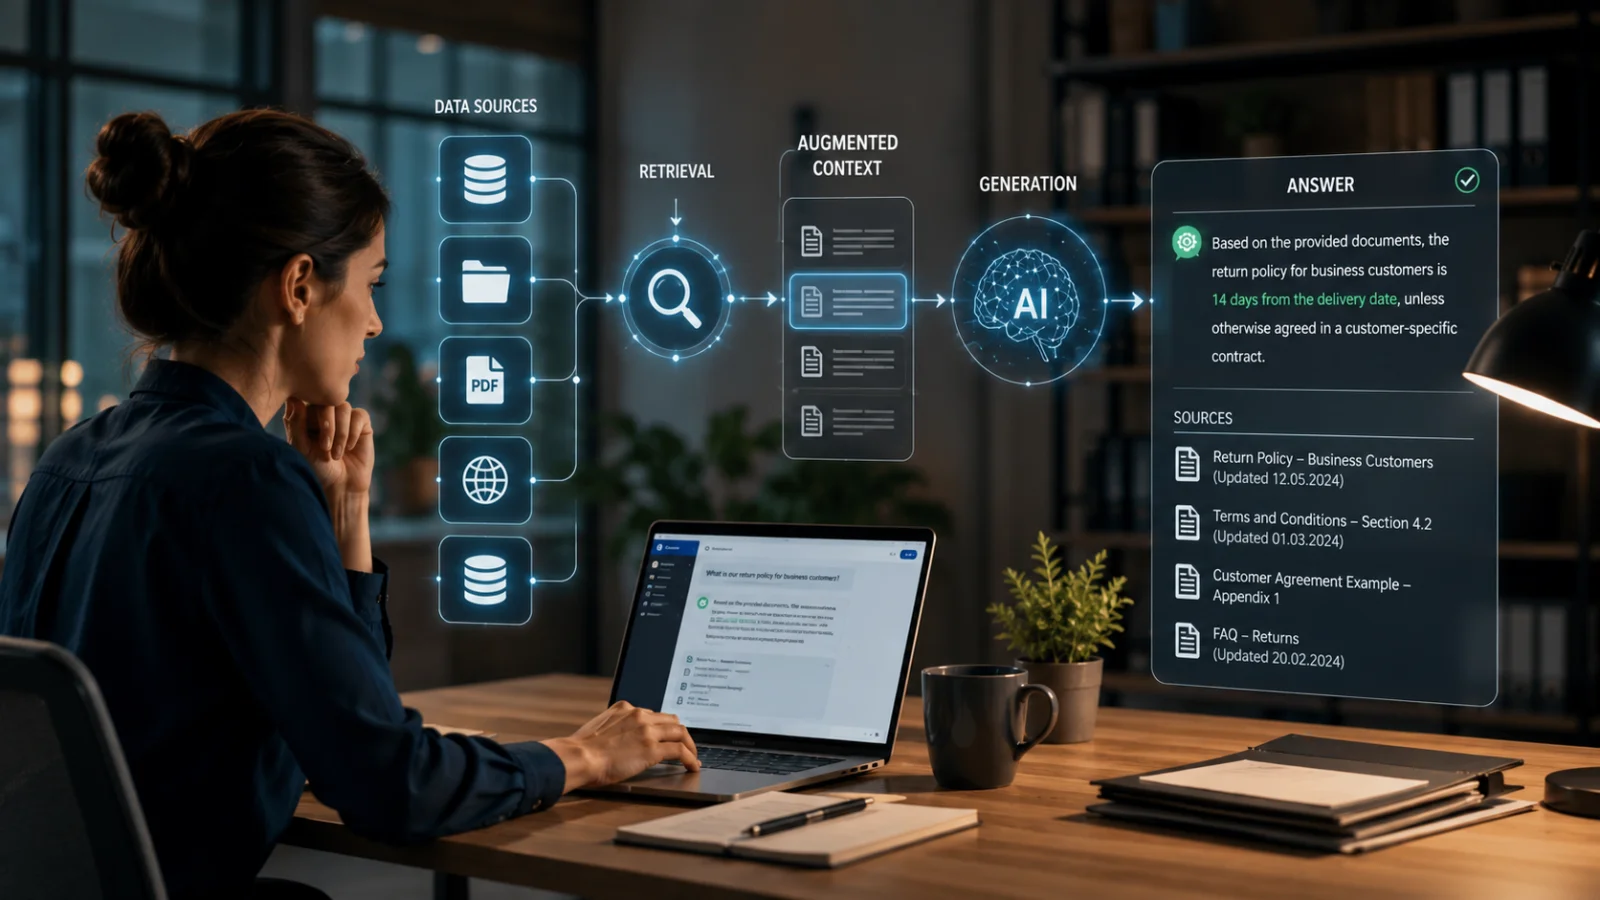
Kratica RAG pomeni Retrieval-Augmented Generation. Združuje tri zamisli:
Retrieval — iskanje informacij
Sistem v zunanjem viru poišče informacije, povezane z uporabnikovim vprašanjem. Vir je lahko na primer:
- interna zbirka znanja podjetja
- dokumentacija izdelka
- navodila za podporo strankam
- intranet
- predloge pogodb
- raziskovalna poročila
- spletne strani
- podatkovna zbirka
- dokumenti PDF
- sistem CRM ali ERP
- pogosta vprašanja
- izobraževalno gradivo
Augmented — dopolnjeno
Najdene informacije se dodajo v kontekst umetne inteligence. Model tako poleg uporabnikovega vprašanja prejme tudi ustrezno gradivo.
Generation — oblikovanje odgovora
Jezikovni model na podlagi najdenih informacij oblikuje odgovor za uporabnika.
Amazon Web Services RAG opredeljuje kot način optimizacije rezultatov velikega jezikovnega modela z uporabo verodostojne zbirke znanja zunaj učnih podatkov. Tako lahko model pripravi natančnejše in uporabnejše odgovore.[2]
Ključna razlika v primerjavi z običajnim odgovorom umetne inteligence je naslednja:
Brez RAG model odgovarja na podlagi tega, kar se je naučil med učenjem, in tega, kar mu uporabnik poda v pogovoru. Z RAG pa za konkretno vprašanje prejme še najdene, natančnejše in pogosto bolj ažurne informacije.
3. Zakaj je nastal RAG?
RAG je nastal za reševanje ene temeljnih težav generativne umetne inteligence: jezikovni modeli so zmogljivi, vendar njihovo znanje ni samodejno ažurno, preverjeno ali prilagojeno posamezni organizaciji.
Velik jezikovni model lahko pozna številna splošna dejstva. Razloži lahko denarni tok, delovanje poslovnega modela SaaS ali pomen zadržanja strank. Ne pozna pa nujno:
- vsebine navodil za izdelke prav vašega podjetja
- najnovejšega cenika
- odločitev iz gradiva za sejo uprave prejšnji teden
- trenutnega postopka podpore strankam
- tega, kaj dovoljuje varnostna politika organizacije
- razlik med določeno različico pogodbe in prejšnjo
- vsebine veljavnih navodil pristojnega organa
IBM Research RAG opisuje kot pristop »odprte knjige«: model ne opravlja izpita brez gradiva, temveč sme odgovor podpreti z zunanjimi viri. Po mnenju IBM sta dve ključni prednosti RAG dostop do ažurnih in zanesljivih dejstev ter možnost, da uporabnik vidi, na katerih virih temelji odgovor.[3]
To je velika sprememba. Običajen jezikovni model je kot razgledan splošni strokovnjak, ki si zapomni veliko, vendar lahko zameša podrobnosti. Model z RAG pa je kot isti strokovnjak s pravimi dokumenti pred seboj.
4. Kako RAG deluje v praksi?
Delovanje sistema RAG lahko opišemo v petih korakih.
1. Zbiranje informacij
Najprej se v sistem uvozi gradivo, na primer:
- dokumenti podjetja
- vsebina spletnih strani
- navodila
- članki v zbirki znanja
- opisi izdelkov
- odgovori podpore strankam
- opisi notranjih postopkov
Ta korak pogosto imenujemo vnos podatkov oziroma uvoz informacij v sistem.
2. Razdelitev informacij na dele
Dolgi dokumenti se razdelijo na manjše odseke, pogosto imenovane »chunki«. Chunk je primerno velik del besedila, denimo nekaj odstavkov ali del strani.
To je pomembno, saj umetni inteligenci pri vsakem vprašanju ni smiselno prebrati celotne knjižnice dokumentov. Najti mora prav prave odlomke.
3. Indeksiranje informacij
Odseki dokumentov se pretvorijo v obliko, ki omogoča učinkovito iskanje. Pogosto se uporabljajo tako imenovane vektorske vložitve oziroma embeddings. Gre za številsko predstavitev besedila: sistem ga pretvori v matematični »prstni odtis«, s katerim lahko poišče pomensko podobne vsebine.
Te predstavitve se pogosto shranijo v vektorsko podatkovno zbirko, zasnovano za iskanje pomensko podobnih vsebin, ne le popolnoma enakih besed.
4. Iskanje ustreznega gradiva za uporabnikovo vprašanje
Ko uporabnik postavi vprašanje, sistem v podatkovni zbirki poišče povezane odseke besedila. Če se vprašanje glasi:
»Kako v našem podjetju poteka vračilo za poslovne stranke?«
Sistem RAG lahko poišče pogoje vračila, navodila za podporo strankam in morebitno pogodbeno prilogo.
5. Jezikovni model oblikuje odgovor na podlagi virov
Nazadnje jezikovni model prejme uporabnikovo vprašanje in najdene odseke. Njegova naloga je iz njih oblikovati jasen odgovor.
Opis storitve Vertex AI RAG Engine v Google Cloudu sledi isti logiki: podatki se vnesejo v sistem, pretvorijo in razdelijo, indeksirajo, poiščejo glede na uporabnikovo vprašanje ter modelu posredujejo kot kontekst. Google poudarja, da dodatni kontekst modelu pomaga odgovarjati natančneje in zmanjšuje halucinacije.[4]
5. RAG skozi preprosto primerjavo
Predstavljajmo si dva strokovnjaka.
Prvi sedi v sejni sobi brez gradiva. Veliko je prebral in govori prepričljivo. Na vprašanja odgovarja po spominu in pogosto pravilno. Toda pri najnovejšem ceniku, natančni določbi pogodbenih pogojev ali odločitvi tega tedna se lahko zmoti.
Drugi sedi v isti sobi, vendar ima dostop do dokumentov podjetja, svežih navodil in iskalnega sistema. Ko dobi vprašanje, najprej poišče pravi odlomek in odgovori na njegovi podlagi.
To je bistvo RAG. Umetna inteligenca zaradi njega ni nezmotljiva, ima pa bolje opremljeno delovno mizo.
NVIDIA RAG primerja s pomočnikom v sodni dvorani: velik jezikovni model je lahko kot sodnik s splošnim znanjem, za posamezen primer pa potrebuje listine, sodno prakso in vire. RAG deluje kot »knjižničar«, ki modelu poišče potrebno gradivo.[5]
Primerjava dobro zadene bistvo RAG: dober odgovor ni le rezultat inteligence, temveč pravih informacij ob pravem času.
6. Kako RAG zmanjšuje halucinacije?
Halucinacija je primer, ko umetna inteligenca ustvari verjetno zveneče, vendar napačne ali izmišljene informacije. RAG jih zmanjšuje tako, da odgovor zasidra v najdenem gradivu.
Brez RAG bi umetna inteligenca lahko odgovorila takole:
»Rok za vračilo v vašem podjetju je 30 dni.«
Z RAG lahko odgovor temelji na dokumentu:
»V skladu s pogodbenimi pogoji je rok za vračilo za poslovne stranke 14 dni, razen če je v pogodbi s posamezno stranko določeno drugače.«
Razlika je ogromna. RAG pomaga predvsem na tri načine.
1. Model dobi dejstveno podlago
Ko model prejme ustrezen dokument, mu odgovora ni treba izmišljati iz nič.
2. Odgovor je mogoče opremiti z viri
Dober sistem RAG pokaže dokument ali odlomek, na katerem temelji odgovor.
3. Uporabnik lahko preveri trditve
Viri omogočajo boljši nadzor nad odgovorom. Uporabnik lahko odpre izvirni dokument in preveri pravilnost odgovora.
Microsoft kot prednosti RAG poudarja manj halucinacij in preglednost virov. RAG lahko poveča zaupanje zlasti na področjih z visokim tveganjem, kot so pravo, zdravstvo in finance, saj uporabnik lahko preveri podlago trditev.[6]
Pomembno pa je vedeti, da RAG halucinacij ne odpravi povsem. Tveganje zmanjša, če iskanje najde prave informacije in jih model pravilno uporabi.
7. Zakaj RAG ohranja odgovore bolj ažurne?
Velik jezikovni model je naučen na določenem gradivu do določenega trenutka, zato njegovo notranje znanje lahko zastara. RAG to težavo rešuje s povezavo modela z zunanjimi viri, ki jih je mogoče posodabljati brez ponovnega učenja celotnega modela.
Za podjetja je to velika prednost.
Ob spremembi cenika ni treba učiti novega jezikovnega modela, temveč se posodobi dokument ali podatkovna zbirka. Enako velja za navodila podpore strankam ali za izvorno gradivo ob spremembi zakonodaje.
IBM med prednostmi RAG izpostavlja dostop do ažurnih podatkov za posamezno panogo in možnost izboljšanja odgovorov umetne inteligence brez dragega ponovnega učenja modela.[7]
Tu se pokaže praktična moč RAG. Umetna inteligenca ni več le model, ki »ve, kar ve«, temveč postane vmesnik do žive zbirke znanja.
8. Uporaba RAG v podjetjih in organizacijah
RAG je eden najpomembnejših načinov, kako generativno umetno inteligenco narediti resnično uporabno za podjetja. Vrednost podjetja namreč ni le v splošnem znanju, temveč v njegovih podatkih, postopkih, strankah in dokumentih.
RAG lahko pomaga na primer pri naslednjih primerih uporabe:
Podpora strankam
Klepetalni robot lahko na vprašanja strank odgovarja na podlagi navodil, pogodbenih pogojev in informacij o izdelkih podjetja.
Prodaja
Prodajalec lahko umetno inteligenco vpraša:
»Kaj moram vedeti o tej stranki pred sestankom?«
RAG lahko poišče zapiske v sistemu CRM, prejšnje ponudbe, zahtevke za podporo in podatke o segmentu stranke.
Kadrovske zadeve
Zaposleni lahko vpraša:
»Kako je v našem podjetju urejen starševski dopust?«
RAG lahko odgovor poišče v kadrovskih navodilih in morebitnih lokalnih pravilih.
Pravne zadeve in skladnost
Pravnik ali ekipa za skladnost lahko išče pogodbene določbe, regulativna navodila in notranje politike.
Razvoj izdelkov
Produktna ekipa lahko analizira odzive strank, zahtevke za podporo in dokumente časovnega načrta izdelka.
Usposabljanje
Novi zaposleni lahko sprašuje o načinu dela organizacije in dobi odgovore na podlagi gradiva za uvajanje.
Amazon Web Services RAG opisuje kot pragmatičen in učinkovit način poslovne uporabe jezikovnih modelov, saj model dobi zunanje podatke, kot so interni dokumenti podjetja, in zato odgovore bolje prilagodi konkretnemu primeru uporabe.[8]
To je poslovno bistvo RAG: umetno inteligenco iz splošnega pisca spremeni v vmesnik za znanje organizacije.
9. RAG v asistentih z umetno inteligenco: kaj mora vedeti uporabnik?
Praktični nasvet:
Asistent z umetno inteligenco, ki temelji na RAG, svoje odgovore opira na ažurne informacije.
Za uporabnika je to pomembna obljuba, vendar jo je treba pravilno razumeti. RAG pomeni, da lahko asistent z umetno inteligenco, preden oblikuje odgovor, poišče podporne informacije v določenih virih. Tako uporabnik ne dobi zgolj ugibanja splošnega jezikovnega modela, temveč odgovor, ki temelji na bazi znanja, ki je sistemu na voljo.
V praksi to lahko na primer pomeni, da asistent z umetno inteligenco, ki temelji na RAG:
- išče informacije v dokumentih organizacije
- uporablja ažurna navodila
- navaja izvorno gradivo
- zmanjšuje tveganje izmišljenih odgovorov
- lahko odgovarja na vprašanja, značilna za organizacijo
- uporabniku pomaga hitreje najti prave informacije
Pošteno pa je treba povedati: RAG nobenega sistema umetne inteligence ne naredi samodejno popolnega. Pri rešitvi RAG je kakovost rezultata med drugim odvisna od tega:
- kako kakovostna je zbirka znanja
- kako ažurni so viri
- ali iskanje najde prave dokumente
- ali model zna pravilno uporabiti najdene informacije
- ali so uporabniku prikazani viri
- kako sistem ravna v negotovih primerih
Dober sistem RAG ne poda le odgovora, temveč uporabniku pomaga razumeti njegovo podlago.
Zato je pri uporabi asistenta, ki temelji na RAG, smiselno zahtevati:
»Pokaži, na katerem viru temelji ta odgovor.«
Ali:
»Če odgovora ni v izvornem gradivu, to jasno povej.«
Tako je uporaba umetne inteligence varnejša in preglednejša.
10. Prednosti RAG: zakaj se o njem toliko govori?
RAG je hitro postal ena najpomembnejših tehnologij generativne umetne inteligence, saj neposredno naslavlja njene praktične pomanjkljivosti.
10.1 Manj halucinacij
Ko odgovor temelji na najdenem gradivu, model manj ugiba.
10.2 Bolj ažurne informacije
Zbirko znanja je mogoče posodobiti brez ponovnega učenja modela.
10.3 Znanje, prilagojeno organizaciji
RAG lahko uporablja lastne podatke podjetja, ki jih splošni jezikovni model ne pozna.
10.4 Večja preglednost
Navedbe virov in povezave do dokumentov uporabniku pomagajo preveriti odgovor.
10.5 Stroškovna učinkovitost
RAG je lahko manj zahtevna možnost kot stalno dodatno ali ponovno učenje modela.
10.6 Hitrejše iskanje informacij
Uporabniku ni treba ročno iskati pravega dokumenta PDF, intranetne strani ali navodil.
10.7 Boljša uporabniška izkušnja
Robot za podporo strankam lahko poda natančnejše odgovore, če uporablja dejanska navodila podjetja.
Google Cloud opisuje RAG kot povezavo med lastnimi podatki organizacije in jezikovnimi sposobnostmi modelov, zaradi katere so odgovori lahko natančnejši, bolj ažurni in ustreznejši za uporabnikove potrebe.[1]
V tem smislu je RAG nekakšno preverjanje resničnosti za umetno inteligenco. Ne ustvarja le besedila, temveč najprej poišče podlago, na kateri ga zgradi.
11. Omejitve RAG: zakaj ni čudežna rešitev?
RAG je učinkovit, vendar ni čaroben. Spodleti lahko na več načinov.
11.1 Iskanje lahko najde napačne informacije
Če sistem poišče napačen dokument ali odlomek, je lahko napačen tudi odgovor. To je klasična težava RAG: generiranje je lahko dobro, iskanje pa spodleti.
11.2 Informacije so lahko zastarele
RAG ohranja odgovore ažurne le, če je ažurna tudi zbirka znanja. Če je v njej staro navodilo, lahko umetna inteligenca odgovori po njem.
11.3 Dokumenti si lahko nasprotujejo
Če ima organizacija tri različice istega navodila, lahko RAG poišče napačno ali jih pomeša.
11.4 Model lahko napačno razume vir
Tudi če najde pravi dokument, ga lahko jezikovni model napačno razume ali preveč posploši.
11.5 Vir morda ne zadošča za odgovor
Če najdeni kontekst ne vsebuje dovolj informacij, bi moral model reči »ne vem«. Vsi sistemi tega ne naredijo dobro.
Google Research je izpostavil pojem sufficient context oziroma zadosten kontekst. Pri sistemih RAG ni dovolj, da so najdene informacije le nekako povezane z vprašanjem; vsebovati morajo dovolj podatkov za pravilen odgovor. Če kontekst ne zadošča, bi moral model prepoznati negotovost, ne pa si izmisliti odgovora.[9]
To je pomembno spoznanje. RAG ni le iskalnik z umetno inteligenco, temveč vprašanje kakovosti: ali sistem najde prav tiste informacije, ki zadoščajo za pravilen odgovor?
11.6 RAG lahko ustvari lažen občutek varnosti
Odgovor z navedbami virov deluje zanesljivo, vendar navedba še ne pomeni, da je odgovor pravilen. Vir je lahko napačen, zastarel ali napačno razumljen. Uporabnik mora zato še vedno preveriti ključne trditve.
12. Kako zgraditi dober sistem RAG?
Dober sistem RAG ne nastane že s povezavo jezikovnega modela in mape dokumentov. Potrebno je skrbno načrtovanje.
12.1 Kakovostna zbirka znanja
Prvo vprašanje je, katere informacije dobi sistem. Če je zbirka znanja nepregledna, zastarela ali protislovna, trpijo tudi odgovori. Dobra zbirka znanja je:
- ažurna
- skrbno urejena
- jasno strukturirana
- z nadzorovanimi različicami
- v upravljanju odgovornih oseb
- zaščitena z upravljanjem pravic dostopa
12.2 Ustrezna razdelitev dokumentov
Če dokumente razdelimo na premajhne dele, izgubimo kontekst; če so deli preveliki, je iskanje lahko nenatančno. Razdeljevanje na odseke je presenetljivo pomembna tehnična odločitev, saj vpliva na to, ali sistem najde pravi odlomek.
12.3 Učinkovit način iskanja
Samo iskanje po ključnih besedah ni vedno dovolj. Vektorsko iskanje najde pomensko podobne vsebine, tudi če besede niso povsem enake. Pogosto je najboljša rešitev hibridno iskanje, ki združuje iskanje po ključnih besedah in semantično iskanje.
12.4 Prikaz virov
Uporabnik mora videti, na čem temelji odgovor. Dober odgovor RAG lahko vsebuje:
- ime dokumenta
- odlomek ali stran
- povezavo do vira
- kratko utemeljitev
- opozorilo o negotovosti, če vir ne zadošča
12.5 Jasna navodila modelu
Model mora dobiti navodila za ravnanje. Na primer:
»Odgovori le na podlagi podanih virov. Če ti ne vsebujejo odgovora, to jasno povej.«
To zmanjšuje ugibanje.
12.6 Ocenjevanje in preizkušanje
Sistem RAG je treba preizkusiti z resničnimi vprašanji. Amazon Web Services poudarja ocenjevanje zanesljivosti aplikacij RAG: med drugim je smiselno meriti zmogljivost, zanesljivost in morebitno pristranskost sistema.[10]
Pri preizkušanju se vprašajte:
- Ali sistem najde pravi vir?
- Ali odgovor temelji na viru?
- Ali model opusti odgovor, kadar informacij ni?
- Ali so viri prikazani uporabniku?
- Ali je odgovor pretirano samozavesten?
- Ali sistem deluje za različne skupine uporabnikov?
Dober RAG je stalen proces, ne enkraten projekt.
13. RAG ali dodatno učenje: kdaj uporabiti katerega?
RAG se pogosto zamenjuje z dodatnim učenjem modela, vendar gre za različni stvari.
RAG
RAG modelu ob odgovarjanju posreduje zunanje informacije. Primeren je, kadar:
- se informacije pogosto spreminjajo
- želimo uporabljati dokumente organizacije
- moramo prikazati vire
- morajo odgovori ostati ažurni
- se želimo izogniti ponovnemu učenju modela
Dodatno učenje
Dodatno učenje pomeni, da se model dodatno uči z določenim gradivom ali za določeno nalogo. Primerno je, kadar:
- želimo spremeniti slog modela
- želimo model naučiti določene oblike odgovora
- želimo izboljšati uspešnost pri omejeni nalogi
- so podatki razmeroma nespremenljivi
- potrebujemo posebno vedenje, ne le novega znanja
Najboljša rešitev pogosto ni izbira enega ali drugega. Podjetje lahko RAG uporablja za ažurne informacije, dodatno učenje pa denimo za določen slog odgovarjanja ali proces.
Če pa je težava v tem, da model ne pozna najnovejših navodil podjetja, je RAG navadno primernejši od dodatnega učenja.
14. Prihodnost: od RAG do agentov in pametnih sistemov za delo z znanjem
RAG je pomemben že danes, njegov pomen pa bo še rasel, ko se umetna inteligenca od klepetalnih robotov pomika k agentom.
Agent je sistem umetne inteligence, ki ne odgovori le na vprašanje, temveč lahko izvede več korakov: poišče informacije, primerja možnosti, uporablja orodja, izdela načrt in morda celo opravi naloge.
RAG je temeljna infrastruktura za takšne agente. Če naj agent pomaga zaposlenemu, mora vedeti:
- kaj določajo navodila organizacije
- kaj je stranka storila v preteklosti
- kaj se dogaja v sistemih
- katera pravila je treba upoštevati
- katere dokumente je dovoljeno uporabljati
- na čem temeljijo informacije
IBM opisuje pristop agentic RAG, pri katerem se sistem RAG poveže z agentskimi zmožnostmi: informacije lahko poišče v zunanji zbirki znanja in jih uporabi za natančnejše odgovore, prilagojene panogi, ne da bi se model zanašal le na svoje učne podatke.[11]
V prihodnosti uporabnik RAG morda ne bo zaznal kot ločene tehnologije. Opazil bo le boljše odgovore.
Uporabnik vpraša, sistem pa:
- poišče prave vire
- oceni njihovo zadostnost
- oblikuje odgovor
- prikaže vire
- opozori na negotovost
- predlaga naslednji korak
To je velik korak k umetni inteligenci, ki ne zveni le pametno, temveč zanesljiveje sodeluje pri vsakdanjem delu.
15. Sklepne ugotovitve: kaj si velja zapomniti?
RAG je ena najpomembnejših tehnologij za uvajanje generativne umetne inteligence v resnično delovno okolje. Rešuje tri velike težave:
- znanje umetne inteligence je lahko zastarelo
- umetna inteligenca ne pozna podatkov organizacije
- umetna inteligenca lahko prepričljivo halucinira
RAG umetne inteligence ne naredi popolne, naredi pa jo uporabnejšo, lažje preverljivo in tesneje povezano z dejanskimi informacijami.
Ključne ugotovitve so:
1. RAG pomeni, da umetna inteligenca najprej poišče informacije in šele nato odgovori
Po tem se razlikuje od običajnega odgovora jezikovnega modela.
2. RAG zmanjšuje halucinacije, vendar jih ne odpravi povsem
Napačno iskanje, zastarel vir ali slaba razlaga lahko še vedno povzročijo napako.
3. Viri so velika prednost RAG
Ko je odgovor mogoče povezati z dokumentom, ga uporabnik lahko preveri.
4. Ažurnost je odvisna od zbirke znanja
RAG je tako dober, kot so dobri podatki, ki jih uporablja.
5. V podjetjih je RAG ključ do uporabe notranjega znanja
Intranet, mapo dokumentov in zbirko navodil lahko spremeni v pogovorni vmesnik.
6. Pri asistentu, ki temelji na RAG, zahtevajte prikaz virov
Uporabnik naj vpraša: »Na čem temelji ta odgovor?«
7. Najboljši RAG včasih reče: »Ne vem«
Zanesljiv sistem si ne izmisli odgovora, kadar viri ne zadoščajo.
Bistvo RAG je preprosto: umetna inteligenca je boljša, kadar ji ni treba odgovarjati sama.
Ko model dobi prave informacije, vire in kontekst, lahko pomaga veliko bolj kot splošni klepetalni robot. Ni več le stroj za besedilo, temveč iskalec informacij, razlagalec in sodelavec — če človek še naprej sprašuje, preverja in uporablja lastno presojo.
16. Praktični pozivi za uporabo sistema RAG
Spodaj so predloge pozivov, ki jih lahko uporabite s katero koli rešitvijo umetne inteligence, ki temelji na RAG.
16.1 Odgovor na podlagi virov
Odgovori le na podlagi razpoložljivih virov.
Če odgovora ni v virih, reci: »V razpoložljivem gradivu ne najdem odgovora na to vprašanje.«
Na konec odgovora dodaj vire ali dokumente, na katerih temelji.
16.2 Prepoznavanje negotovosti
Na vprašanje odgovori na podlagi virov. V odgovoru loči:
1) kaj viri zanesljivo navajajo
2) kaj je mogoče sklepati
3) česa iz podanega gradiva ni mogoče sklepati
16.3 Primerjava dokumentov
Primerjaj te vire med seboj.
Poišči nasprotja, prekrivanja in mesta, kjer novejši dokument očitno nadomešča starejšega.
Ne sklepaj ničesar, česar viri ne podpirajo.
16.4 Odgovor za podporo strankam
Na podlagi izvornega gradiva pripravi jasen odgovor za stranko.
Uporabi prijazen in strokoven ton.
Ne obljubljaj ničesar, kar ni navedeno v virih.
Če mora zadevo preveriti človek, to jasno povej.
16.5 Podpora pri odločanju
Na podlagi izvornega gradiva pripravi kratko analizo teme. Navedi:
• ključna dejstva
• morebitna tveganja
• odprta vprašanja
• kaj je treba preveriti pred odločitvijoNe dodajaj zunanjih informacij brez posebne oznake.
16.6 Preverjanje odgovora RAG
Preveri svoj prejšnji odgovor.
Vsako ključno trditev označi z ustreznim virom.
Če katera trditev ne temelji na viru, jo odstrani ali označi kot domnevo.
Praktični povzetek
Če nas prompt engineering uči bolje spraševati umetno inteligenco, jo RAG uči odgovarjati iz boljših virov. To je ključna razlika.
Običajna umetna inteligenca lahko zveni pravilno. Umetna inteligenca z RAG pa lahko pokaže, na čem temelji njen odgovor. Prav zato je ta tehnologija tako pomembna za podjetja, strokovnjake in vse, ki želijo umetno inteligenco uporabljati tudi za kaj več kot zbiranje idej.
Praktični nasvet: ko uporabljaš asistenta, ki temelji na RAG, zahtevaj prikaz virov in opozorilo, če odgovora ni v gradivu. To je majhen korak k večjemu zaupanju v uporabo umetne inteligence.
Viri
- What is Retrieval-Augmented Generation (RAG)? — Google Cloud
- What is RAG? Retrieval-Augmented Generation AI — Amazon Web Services
- What is retrieval-augmented generation (RAG)? — IBM Research
- Vertex AI RAG Engine overview — Google Cloud Documentation
- What Is Retrieval-Augmented Generation aka RAG — NVIDIA Blog
- 5 key features and benefits of retrieval augmented generation — Microsoft
- O que é RAG (retrieval-augmented generation)? — IBM
- Understanding Retrieval Augmented Generation — AWS Prescriptive Guidance
- Deeper insights into retrieval augmented generation — Google Research
- Evaluate the reliability of RAG applications — AWS Machine Learning Blog
- What is Agentic RAG? — IBM