
1. Johdanto: miksi pelkkä tekoäly ei aina riitä?
Tekoäly osaa kirjoittaa hämmästyttävän sujuvasti.
Se voi selittää monimutkaisen käsitteen, tiivistää raportin, luonnostella asiakasviestin tai auttaa hahmottamaan strategiaa. Mutta samalla sen suurin heikkous on tullut monelle tutuksi: se voi vastata itsevarmasti myös silloin, kun sillä ei ole riittävää tietoa. Se voi kuulostaa asiantuntijalta, vaikka se arvaa.
Tämä on erityisen iso ongelma työelämässä. Yrityksissä tekoälyltä ei yleensä haluta vain kaunista tekstiä. Siltä halutaan vastauksia, jotka perustuvat oikeisiin dokumentteihin, ajantasaiseen tietoon, sisäisiin ohjeisiin, asiakasdataan tai luotettaviin lähteisiin.
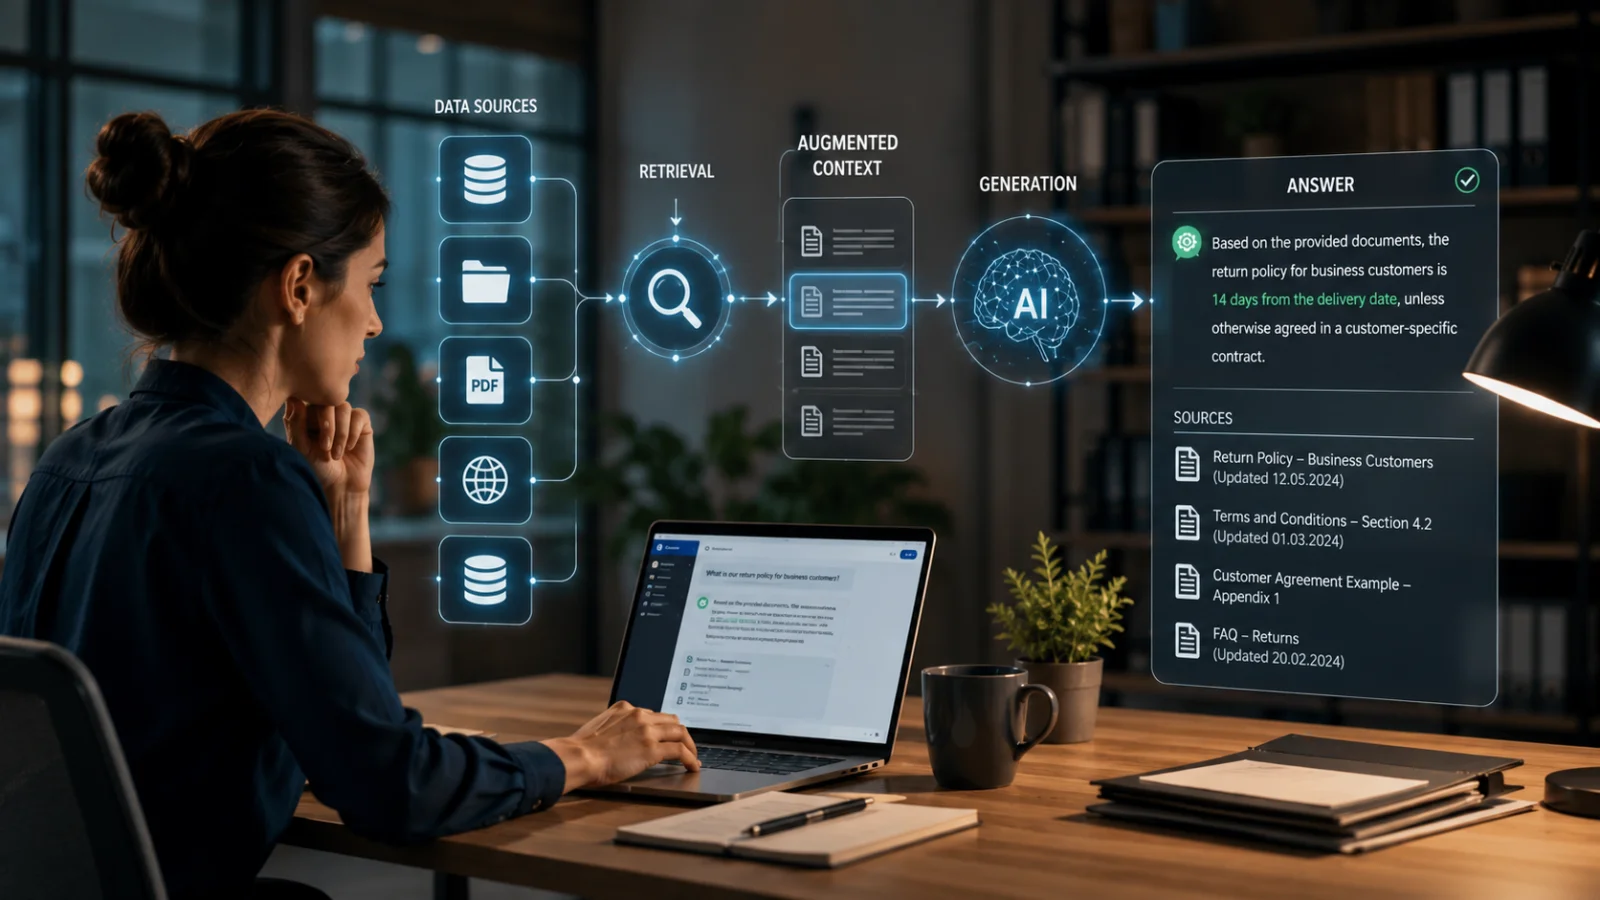
Tähän tarpeeseen syntyi RAG, eli Retrieval-Augmented Generation.
Suomeksi sen voisi kääntää kömpelösti ”hakua hyödyntäväksi generoinniksi”. Käytännössä kyse on tekniikasta, jossa tekoäly ei vastaa pelkästään muistinsa tai koulutusdatansa varassa, vaan hakee ensin tietoa määritellystä lähteestä ja muodostaa vastauksen sen perusteella.
Google Cloud kuvaa RAGia tekoälykehyksenä, joka yhdistää perinteisen tiedonhaun, kuten hakujärjestelmät ja tietokannat, generatiivisten kielimallien kykyyn tuottaa luonnollista kieltä. Tavoitteena on tehdä vastauksista tarkempia, ajantasaisempia ja paremmin käyttäjän omaan tarpeeseen sopivia.[1]
Yksinkertaisemmin: RAG antaa tekoälylle kirjastokortin. Sen sijaan, että malli yrittäisi vastata pelkästä muistista, se saa mahdollisuuden tarkistaa relevantit tiedot ennen vastaamista.
2. Mitä RAG tarkoittaa?
RAG tulee sanoista Retrieval-Augmented Generation. Se koostuu kolmesta ideasta:
Retrieval — tiedonhaku
Järjestelmä etsii käyttäjän kysymykseen liittyvää tietoa ulkoisesta lähteestä. Lähde voi olla esimerkiksi:
- yrityksen sisäinen tietopankki
- tuotedokumentaatio
- asiakastukiohjeet
- intranet
- sopimuspohjat
- tutkimusraportit
- verkkosivut
- tietokanta
- PDF-dokumentit
- CRM- tai ERP-järjestelmä
- usein kysytyt kysymykset
- koulutusmateriaalit
Augmented — täydennetty
Haettu tieto lisätään tekoälyn kontekstiin. Mallille annetaan siis käyttäjän kysymyksen lisäksi asiaan liittyvä aineisto.
Generation — vastauksen tuottaminen
Kielimalli muodostaa vastauksen käyttäjälle haetun tiedon perusteella.
Amazon Web Services määrittelee RAGin tavaksi optimoida suuren kielimallin tuotosta niin, että se viittaa koulutusdatan ulkopuoliseen, auktoritatiiviseen tietopohjaan. Tämä auttaa mallia tuottamaan tarkempia ja käyttökelpoisempia vastauksia.[2]
Tärkeä ero tavalliseen tekoälyvastaukseen on tämä:
Ilman RAGia malli vastaa sen perusteella, mitä se on oppinut koulutuksessa ja mitä käyttäjä antaa keskustelussa. RAGin kanssa malli saa lisäksi haettua, tarkempaa ja usein ajantasaisempaa tietoa juuri käsillä olevaan kysymykseen.
3. Miksi RAG syntyi?
RAG syntyi ratkaisemaan yhtä generatiivisen tekoälyn perusongelmaa: kielimallit ovat vaikuttavia, mutta niiden tieto ei ole automaattisesti ajantasaista, tarkistettua tai organisaatiokohtaista.
Suuri kielimalli voi tietää paljon yleismaailmallisia asioita. Se voi selittää, mitä on kassavirta, miten SaaS-liiketoiminta toimii tai miksi asiakaspysyvyys on tärkeää. Mutta se ei välttämättä tiedä:
- mitä juuri sinun yrityksesi tuoteohjeissa lukee
- mikä on uusin hinnasto
- mitä viime viikon hallituksen materiaalissa päätettiin
- mikä on tämän päivän asiakastukikäytäntö
- mitä organisaation tietoturvapolitiikka sallii
- miten tietty sopimusversio eroaa edellisestä
- mitä ajantasainen viranomaisohje sanoo
IBM Research kuvaa RAGia ”open book” -lähestymistapana: malli ei vastaa suljetun kirjan kokeessa, vaan saa käyttää ulkoisia lähteitä vastauksensa tueksi. IBM:n mukaan RAGin kaksi keskeistä hyötyä ovat pääsy ajantasaisiin ja luotettaviin faktoihin sekä se, että käyttäjä voi nähdä, mihin lähteisiin vastaus perustuu.[3]
Tämä on iso muutos. Perinteinen kielimalli on kuin fiksu yleisasiantuntija, joka muistaa paljon mutta voi sekoittaa yksityiskohtia. RAG-malli on kuin sama asiantuntija, jolla on edessään oikeat dokumentit.
4. Miten RAG toimii käytännössä?
RAG-järjestelmän toiminta voidaan kuvata viidessä vaiheessa.
1. Tieto kerätään
Ensin järjestelmään tuodaan aineistoa. Se voi olla esimerkiksi:
- yrityksen dokumentteja
- verkkosivujen sisältöä
- ohjeita
- tietokanta-artikkeleita
- tuotekuvauksia
- asiakastuen vastauksia
- sisäisiä prosessikuvauksia
Tätä vaihetta kutsutaan usein datan ingestoinniksi eli tiedon tuomiseksi järjestelmään.
2. Tieto pilkotaan osiin
Pitkät dokumentit jaetaan pienempiin osiin, joita kutsutaan usein chunkeiksi. Chunk tarkoittaa sopivan kokoista tekstipalaa, esimerkiksi muutamaa kappaletta tai sivun osaa.
Tämä on tärkeää, koska tekoälyn ei yleensä kannata lukea koko dokumenttikirjastoa jokaista kysymystä varten. Sen pitää löytää juuri oikeat kohdat.
3. Tieto indeksoidaan
Dokumenttipalat muunnetaan muotoon, jossa niitä voidaan hakea tehokkaasti. Usein käytetään niin sanottuja embeddingeja. Embedding tarkoittaa tekstin numeerista esitystä: järjestelmä muuttaa tekstin matemaattiseksi ”sormenjäljeksi”, jonka avulla samankaltaisia sisältöjä voidaan löytää.
Nämä tallennetaan usein vektoritietokantaan. Se on tietokanta, joka on suunniteltu löytämään merkitykseltään samankaltaisia sisältöjä, ei vain täsmälleen samoja sanoja.
4. Käyttäjän kysymykseen haetaan relevantti aineisto
Kun käyttäjä kysyy jotain, järjestelmä etsii tietokannasta siihen liittyvät tekstipalat. Jos kysymys on:
”Miten yrityksemme palautuskäytäntö toimii yritysasiakkaille?”
RAG-järjestelmä voi hakea palautusehdot, asiakaspalveluohjeen ja mahdollisen sopimusliitteen.
5. Kielimalli muodostaa vastauksen lähteiden perusteella
Lopuksi kielimalli saa käyttäjän kysymyksen ja haetut tekstipalat. Sen tehtävä on muodostaa selkeä vastaus niiden perusteella.
Google Cloudin Vertex AI RAG Engine -kuvauksessa prosessi etenee samalla logiikalla: data tuodaan järjestelmään, muunnetaan ja pilkotaan, indeksoidaan, haetaan käyttäjän kysymykseen liittyen ja annetaan mallille kontekstiksi. Google korostaa, että lisäkonteksti auttaa mallia vastaamaan tarkemmin ja vähentämään hallusinaatioita.[4]
5. RAG yksinkertaisella vertauksella
Kuvitellaan kaksi asiantuntijaa.
Ensimmäinen asiantuntija istuu kokoushuoneessa ilman materiaaleja. Hän on lukenut paljon ja osaa puhua vakuuttavasti. Kun häneltä kysytään jotain, hän vastaa muistinsa perusteella. Usein vastaus on hyvä. Mutta jos kysytään viimeisintä hinnastoa, sopimusehtojen tarkkaa kohtaa tai tämän viikon päätöstä, hän voi erehtyä.
Toinen asiantuntija istuu samassa huoneessa, mutta hänellä on pääsy yrityksen dokumentteihin, tuoreisiin ohjeisiin ja hakujärjestelmään. Kun häneltä kysytään jotain, hän hakee ensin oikean kohdan ja vastaa sen perusteella.
Tämä on RAGin idea. Se ei tee tekoälystä erehtymätöntä. Mutta se antaa sille paremman työpöydän.
NVIDIA vertaa RAGia oikeussalin apulaiseen: suuri kielimalli voi olla kuin tuomari, jolla on yleinen ymmärrys, mutta tiettyyn tapaukseen tarvitaan asiakirjoja, ennakkotapauksia ja lähteitä. RAG toimii ”kirjastonhoitajana”, joka hakee mallille tarvittavan aineiston.[5]
Vertaus on osuva, koska se paljastaa RAGin ytimen: hyvä vastaus ei synny vain älystä. Se syntyy oikeasta tiedosta oikealla hetkellä.
6. Miten RAG vähentää hallusinaatioita?
Hallusinaatio tarkoittaa tilannetta, jossa tekoäly tuottaa uskottavan kuuloista mutta virheellistä tai keksittyä tietoa. RAG vähentää hallusinaatioita, koska se ankkuroi vastauksen haettuun aineistoon.
Ilman RAGia tekoäly voi vastata näin:
”Yrityksenne palautusaika on 30 päivää.”
RAGin kanssa vastaus voi perustua dokumenttiin:
”Yritysasiakkaiden palautusaika on sopimusehtojen mukaan 14 päivää, ellei asiakaskohtaisessa sopimuksessa ole muuta sovittu.”
Ero on valtava. RAG auttaa erityisesti kolmella tavalla.
1. Malli saa faktapohjan
Kun malli saa relevantin dokumentin, sen ei tarvitse keksiä vastausta tyhjästä.
2. Vastaus voidaan lähteistää
Hyvä RAG-järjestelmä näyttää, mihin dokumenttiin tai kohtaan vastaus perustuu.
3. Käyttäjä voi tarkistaa väitteet
Lähteet tekevät vastauksesta auditoitavamman. Käyttäjä voi avata alkuperäisen dokumentin ja katsoa, pitääkö vastaus paikkansa.
Microsoft korostaa RAGin hyötynä hallusinaatioiden vähentämistä ja lähteiden läpinäkyvyyttä. Sen mukaan RAG voi lisätä luottamusta erityisesti korkean riskin aloilla, kuten juridiikassa, terveydenhuollossa ja rahoituksessa, koska käyttäjä voi tarkistaa, mihin väitteet perustuvat.[6]
Mutta tärkeä huomio: RAG ei poista hallusinaatioita kokonaan. Se vähentää riskiä, jos haku löytää oikean tiedon ja malli käyttää sitä oikein.
7. Miksi RAG pitää vastaukset ajantasaisempina?
Suuri kielimalli on koulutettu tietyllä aineistolla tiettyyn ajankohtaan asti. Sen sisäinen tieto voi vanhentua. RAG ratkaisee tätä ongelmaa liittämällä mallin ulkoisiin tietolähteisiin, joita voidaan päivittää ilman, että koko mallia koulutetaan uudelleen.
Tämä on yrityksille valtava etu.
Jos hinnasto muuttuu, ei tarvitse kouluttaa uutta kielimallia — päivitetään hinnastodokumentti tai tietokanta. Jos asiakastukiohje muuttuu, päivitetään ohje. Jos lainsäädäntö muuttuu, päivitetään lähdeaineisto.
IBM nostaa RAGin hyödyiksi pääsyn ajantasaiseen ja toimialakohtaiseen dataan sekä sen, että organisaatiot voivat parantaa tekoälyn vastauksia ilman kallista mallin uudelleenkoulutusta.[7]
Tässä RAGin käytännön voima näkyy. Tekoäly ei ole enää vain malli, joka ”tietää mitä tietää”. Siitä tulee käyttöliittymä elävään tietopohjaan.
8. RAG yritysten ja organisaatioiden käytössä
Yrityksissä RAG on yksi tärkeimmistä tavoista tehdä generatiivisesta tekoälystä aidosti hyödyllinen. Miksi? Koska yritysten arvo ei yleensä ole vain yleisessä tiedossa. Se on omassa datassa, omissa prosesseissa, omissa asiakkaissa ja omissa dokumenteissa.
RAG voi auttaa esimerkiksi näissä käyttötapauksissa:
Asiakaspalvelu
Chatbot voi vastata asiakkaan kysymyksiin yrityksen omien ohjeiden, sopimusehtojen ja tuotetietojen perusteella.
Predaj
Myyjä voi kysyä tekoälyltä:
”Mitä tästä asiakkaasta kannattaa huomioida ennen tapaamista?”
RAG voi hakea CRM-muistiinpanoja, aiempia tarjouksia, tukipyyntöjä ja asiakassegmentin tietoja.
HR
Työntekijä voi kysyä:
”Miten vanhempainvapaa toimii meidän yrityksessämme?”
RAG voi hakea vastauksen henkilöstöohjeista ja mahdollisista paikallisista käytännöistä.
Lakiasiat ja compliance
Juristi tai compliance-tiimi voi hakea sopimuskohtia, sääntelyohjeita ja sisäisiä politiikkoja.
Tuotekehitys
Tuotetiimi voi analysoida asiakaspalautetta, tukipyyntöjä ja roadmap-dokumentteja.
Koulutus
Uusi työntekijä voi kysyä organisaation toimintatavoista ja saada vastauksia perehdytysmateriaalien perusteella.
Amazon Web Services kuvaa RAGia pragmaattiseksi ja tehokkaaksi tavaksi käyttää kielimalleja yrityksissä, koska se antaa mallille ulkoista dataa, kuten yrityksen sisäisiä dokumentteja, joiden avulla vastaukset sopivat paremmin tiettyyn käyttötapaukseen.[8]
Tässä on RAGin liiketoiminnallinen ydin: se muuttaa tekoälyn yleisestä kirjoittajasta organisaation tietotyön käyttöliittymäksi.
9. RAG tekoälyassistentin käytössä: mitä käyttäjän kannattaa ymmärtää?
Käytännön vinkki kuuluu:
RAG-pohjainen tekoälyassistentti hakee vastauksensa tueksi ajantasaista tietoa.
Tämä on käyttäjän kannalta tärkeä lupaus, mutta se kannattaa ymmärtää oikein. RAG tarkoittaa, että tekoälyassistentti voi hakea vastauksen tueksi tietoa määritellyistä lähteistä ennen kuin se muodostaa vastauksen. Näin käyttäjä ei saa pelkästään yleisen kielimallin arvausta, vaan vastauksen, joka perustuu järjestelmän käytettävissä olevaan tietopohjaan.
Käytännössä tämä voi tarkoittaa esimerkiksi sitä, että RAG-pohjainen tekoälyassistentti:
- hakee tietoa organisaation omista dokumenteista
- käyttää ajantasaisia ohjeita
- viittaa lähdeaineistoon
- vähentää keksittyjen vastausten riskiä
- pystyy vastaamaan organisaatiokohtaisiin kysymyksiin
- auttaa käyttäjää löytämään oikean tiedon nopeammin
Tärkeää on kuitenkin sanoa rehellisesti: RAG ei tee mistään AI-järjestelmästä automaattisesti täydellistä. RAG-ratkaisussa lopputuloksen laatu riippuu muun muassa siitä:
- kuinka laadukas tietopohja on
- kuinka ajantasaisia lähteet ovat
- löytääkö haku oikeat dokumentit
- osaako malli käyttää haettua tietoa oikein
- näytetäänkö käyttäjälle lähteet
- miten epävarmoissa tilanteissa toimitaan
Hyvä RAG-järjestelmä ei vain vastaa. Se auttaa käyttäjää näkemään, mihin vastaus perustuu.
Siksi RAG-pohjaista tekoälyassistenttia käytettäessä kannattaa pyytää:
”Näytä, mihin lähteeseen tämä vastaus perustuu.”
Tai:
”Jos vastaus ei löydy lähdeaineistosta, sano se suoraan.”
Tämä tekee AI:n käytöstä turvallisempaa ja läpinäkyvämpää.
10. RAGin hyödyt: miksi tästä puhutaan niin paljon?
RAG on noussut nopeasti yhdeksi generatiivisen tekoälyn tärkeimmistä tekniikoista, koska se vastaa suoraan tekoälyn käytännön kipupisteisiin.
10.1 Vähemmän hallusinaatioita
Kun vastaus perustuu haettuun aineistoon, malli arvaa vähemmän.
10.2 Ajantasaisempi tieto
Tietopohjaa voidaan päivittää ilman mallin uudelleenkoulutusta.
10.3 Organisaatiokohtainen osaaminen
RAG voi hyödyntää yrityksen omaa dataa, jota yleinen kielimalli ei tunne.
10.4 Parempi läpinäkyvyys
Lähdeviitteet ja dokumenttilinkit auttavat käyttäjää tarkistamaan vastauksen.
10.5 Kustannustehokkuus
RAG voi olla kevyempi vaihtoehto kuin mallin jatkuva hienosäätö tai uudelleenkoulutus.
10.6 Nopeampi tiedon löytäminen
Käyttäjän ei tarvitse etsiä oikeaa PDF:ää, intranet-sivua tai ohjetta käsin.
10.7 Parempi asiakaskokemus
Asiakaspalvelubotti voi antaa tarkempia vastauksia, jos se perustuu yrityksen oikeisiin ohjeisiin.
Google Cloud kuvaa RAGin yhdistävän organisaation oman datan ja kielimallien kielelliset kyvyt, jolloin vastaukset voivat olla tarkempia, ajantasaisempia ja käyttäjän tarpeisiin relevantimpia.[1]
Tässä mielessä RAG on vähän kuin tekoälyn todellisuustarkistus. Se ei vain tuota tekstiä — se hakee ensin maaperän, jolle teksti rakennetaan.
11. RAGin rajat: miksi se ei ole taikaratkaisu?
RAG on tehokas, mutta ei maaginen. Se voi epäonnistua monella tavalla.
11.1 Haku voi löytää väärän tiedon
Jos järjestelmä hakee väärän dokumentin tai väärän kohdan, vastaus voi mennä pieleen. Tämä on RAGin klassinen ongelma: generointi voi olla hyvä, mutta retrieval eli haku epäonnistuu.
11.2 Tieto voi olla vanhentunutta
RAG pitää vastaukset ajantasaisina vain, jos tietopohja on ajantasainen. Jos tietokannassa on vanha ohje, tekoäly voi vastata vanhan ohjeen mukaan.
11.3 Dokumentit voivat olla ristiriitaisia
Jos organisaatiossa on kolme eri versiota samasta ohjeesta, RAG voi hakea niistä väärän tai sekoittaa ne.
11.4 Malli voi tulkita lähteen väärin
Vaikka oikea dokumentti löytyy, kielimalli voi ymmärtää sen väärin tai yleistää liikaa.
11.5 Lähde ei ehkä riitä vastaamiseen
Jos haettu konteksti ei sisällä riittävää tietoa, mallin pitäisi sanoa ”en tiedä”. Kaikki järjestelmät eivät tee tätä hyvin.
Google Research on nostanut esiin käsitteen sufficient context, eli riittävä konteksti. Sen mukaan RAG-järjestelmissä ei riitä, että haettu tieto on jollain tavalla relevanttia. Sen pitää olla riittävää, jotta kysymykseen voidaan vastata oikein. Jos konteksti ei riitä, mallin pitäisi mieluummin tunnistaa epävarmuus kuin keksiä vastaus.[9]
Tämä on tärkeä oivallus. RAG ei ole vain hakukone plus tekoäly. Se on laatukysymys: löytyykö juuri se tieto, joka riittää oikeaan vastaukseen?
11.6 RAG voi antaa väärän turvallisuuden tunteen
Kun vastauksessa on lähdeviitteitä, se näyttää luotettavalta. Mutta lähdeviite ei automaattisesti tarkoita, että vastaus on oikein. Lähde voi olla väärä, vanha tai väärin tulkittu. Siksi käyttäjän pitää edelleen tarkistaa kriittiset väitteet.
12. Miten hyvä RAG-järjestelmä rakennetaan?
Hyvä RAG-järjestelmä ei synny vain yhdistämällä kielimalli ja dokumenttikansio. Se vaatii huolellista suunnittelua.
12.1 Laadukas tietopohja
Ensimmäinen kysymys on: mitä tietoa järjestelmään annetaan? Jos tietopohja on sekava, vanha tai ristiriitainen, myös vastaukset kärsivät. Hyvä tietopohja on:
- ajantasainen
- kuratoitu
- selkeästi jäsennelty
- versioitu
- vastuuhenkilöiden ylläpitämä
- käyttöoikeuksiltaan hallittu
12.2 Hyvä dokumenttien pilkkominen
Jos dokumentit pilkotaan liian pieniksi, konteksti katoaa. Jos ne pilkotaan liian suuriksi, haku voi muuttua epätarkaksi. Chunking on yllättävän tärkeä tekninen valinta. Se vaikuttaa siihen, löytääkö järjestelmä oikean kohdan.
12.3 Toimiva hakumenetelmä
Pelkkä avainsanahaku ei aina riitä. Vektorihaku löytää merkitykseltään samankaltaista sisältöä, vaikka sanat eivät olisi täsmälleen samoja. Usein paras ratkaisu on hybridihaku, joka yhdistää avainsanahaun ja semanttisen haun.
12.4 Lähteiden näyttäminen
Käyttäjän pitää nähdä, mihin vastaus perustuu. Hyvä RAG-vastaus voi sisältää:
- dokumentin nimen
- kohdan tai sivun
- linkin lähteeseen
- lyhyen perustelun
- epävarmuuden, jos lähde ei riitä
12.5 Selkeät ohjeet mallille
Mallille pitää kertoa, miten sen tulee toimia. Esimerkiksi:
”Vastaa vain annettujen lähteiden perusteella. Jos lähteet eivät sisällä vastausta, sano se suoraan.”
Tämä vähentää arvaamista.
12.6 Arviointi ja testaus
RAG-järjestelmää pitää testata oikeilla kysymyksillä. Amazon Web Services korostaa RAG-sovellusten luotettavuuden arviointia: järjestelmää kannattaa mitata muun muassa suorituskyvyn, luotettavuuden ja mahdollisten vinoumien näkökulmasta.[10]
Testauksessa kannattaa kysyä:
- Löytyykö oikea lähde?
- Perustuuko vastaus lähteeseen?
- Jättääkö malli vastaamatta, jos tietoa ei ole?
- Näkyvätkö lähteet käyttäjälle?
- Onko vastaus liian varma?
- Toimiiko järjestelmä eri käyttäjäryhmille?
Hyvä RAG on jatkuva prosessi, ei kertaprojekti.
13. RAG vs. hienosäätö: milloin kumpaa tarvitaan?
RAG sekoitetaan usein mallin hienosäätöön. Ne ovat eri asioita.
RAG
RAG antaa mallille ulkoista tietoa vastaushetkellä. Se sopii, kun:
- tieto muuttuu usein
- halutaan käyttää organisaation dokumentteja
- lähteet pitää näyttää
- vastaukset pitää pitää ajantasaisina
- halutaan välttää mallin uudelleenkoulutusta
Hienosäätö
Hienosäätö tarkoittaa, että mallia koulutetaan lisää tietyllä aineistolla tai tiettyyn tehtävään. Se sopii, kun:
- halutaan muuttaa mallin tyyliä
- halutaan opettaa tietty vastausmuoto
- halutaan parantaa suoriutumista rajatussa tehtävässä
- data on suhteellisen pysyvää
- tarvitaan erityistä käyttäytymistä, ei vain uutta tietoa
Usein paras ratkaisu ei ole joko-tai. Yritys voi käyttää RAGia ajantasaiseen tietoon ja hienosäätöä esimerkiksi tietyn vastaustyylin tai prosessin opettamiseen.
Mutta jos ongelma on ”malli ei tiedä meidän uusimpia ohjeita”, RAG on yleensä luontevampi ratkaisu kuin hienosäätö.
14. Tulevaisuus: RAGista kohti agentteja ja älykkäitä tietotyön järjestelmiä
RAG on jo nyt tärkeä, mutta sen merkitys kasvaa, kun tekoäly siirtyy pelkistä chatboteista kohti agentteja.
Agentti tarkoittaa tekoälyjärjestelmää, joka ei vain vastaa kysymykseen, vaan voi tehdä useita vaiheita: hakea tietoa, vertailla vaihtoehtoja, käyttää työkaluja, muodostaa suunnitelman ja ehkä jopa suorittaa tehtäviä.
RAG on tällaisille agenteille perusinfrastruktuuria. Jos agentin pitää auttaa työntekijää, sen täytyy tietää:
- mitä organisaation ohjeissa sanotaan
- mitä asiakas on aiemmin tehnyt
- mitä järjestelmissä tapahtuu
- mitä sääntöjä pitää noudattaa
- mitä dokumentteja saa käyttää
- mihin tieto perustuu
IBM kuvaa agentic RAG -lähestymistapaa, jossa RAG-järjestelmä yhdistyy agenttimaisiin kyvykkyyksiin: järjestelmä voi hakea tietoa ulkoisesta tietopohjasta ja käyttää sitä tarkempien, toimialakohtaisten vastausten tuottamiseen ilman, että malli nojaa vain koulutusdataansa.[11]
Tulevaisuudessa RAG ei ehkä näy käyttäjälle erillisenä tekniikkana. Se näkyy parempina vastauksina.
Käyttäjä kysyy, ja järjestelmä:
- hakee oikeat lähteet
- arvioi niiden riittävyyden
- muodostaa vastauksen
- näyttää lähteet
- kertoo epävarmuuden
- ehdottaa seuraavaa toimenpidettä
Tämä on iso askel kohti tekoälyä, joka ei vain kuulosta fiksulta, vaan toimii luotettavammin osana arjen työtä.
15. Johtopäätökset: mitä tästä kannattaa oppia?
RAG on yksi tärkeimmistä tekniikoista, kun generatiivista tekoälyä viedään oikeaan työelämään. Se ratkaisee kolme isoa ongelmaa:
- tekoälyn tieto voi olla vanhentunutta
- tekoäly ei tunne organisaation omaa dataa
- tekoäly voi hallusinoida vakuuttavasti
RAG ei tee tekoälystä täydellistä. Mutta se tekee siitä käyttökelpoisemman, tarkistettavamman ja paremmin sidotun todelliseen tietoon.
Najdôležitejšie poznatky sú tieto:
1. RAG tarkoittaa, että AI hakee ensin tietoa ja vastaa vasta sitten
Tämä erottaa sen tavallisesta kielimallivastauksesta.
2. RAG vähentää hallusinaatioita, mutta ei poista niitä kokonaan
Väärä haku, vanha lähde tai huono tulkinta voi silti johtaa virheeseen.
3. Lähteet ovat RAGin suuri vahvuus
Kun vastaus voidaan jäljittää dokumenttiin, käyttäjä voi tarkistaa sen.
4. Ajantasaisuus riippuu tietopohjasta
RAG on niin hyvä kuin sen käyttämä data.
5. Yrityksissä RAG on avain sisäisen tiedon hyödyntämiseen
Se voi muuttaa intranetin, dokumenttikansion ja ohjepankin keskustelevaksi käyttöliittymäksi.
6. RAG-pohjaista tekoälyassistenttia käytettäessä kannattaa pyytää lähteet näkyviin
Käyttäjän kannattaa kysyä: ”Mihin tämä vastaus perustuu?”
7. Paras RAG sanoo joskus: ”En tiedä”
Luotettava järjestelmä ei keksi vastausta, jos lähteet eivät riitä.
RAGin ydin on lopulta yksinkertainen: tekoälystä tulee parempi, kun se ei joudu vastaamaan yksin.
Kun malli saa tuekseen oikean tiedon, oikeat lähteet ja oikean kontekstin, se voi auttaa paljon enemmän kuin pelkkä yleinen chatbot. Se ei ole enää vain tekstikone. Se on tiedonhakija, tulkitsija ja työpari — kunhan ihminen muistaa edelleen kysyä, tarkistaa ja käyttää omaa harkintaansa.
16. Käytännön promptit RAG-järjestelmän käyttöön
Alla on promptimalleja, joita voi käyttää minkä tahansa RAG-pohjaisen tekoälyratkaisun kanssa.
16.1 Lähteisiin perustuva vastaus
Vastaa vain käytettävissä olevien lähteiden perusteella.
Jos vastausta ei löydy lähteistä, sano: ”En löydä tähän vastausta käytettävissä olevasta aineistosta.”
Lisää vastauksen loppuun lähteet tai dokumentit, joihin vastaus perustuu.
16.2 Epävarmuuden tunnistaminen
Vastaa kysymykseen lähteiden perusteella. Erottele vastauksessa:
1) mitä lähteet sanovat varmasti
2) mitä voidaan päätellä
3) mitä ei voida päätellä annetusta aineistosta
16.3 Dokumenttien vertailu
Vertaa näitä lähteitä keskenään.
Etsi ristiriidat, päällekkäisyydet ja kohdat, joissa uudempi dokumentti näyttää korvaavan vanhemman.
Älä tee johtopäätöksiä, joita lähteet eivät tue.
16.4 Asiakaspalveluvastaus
Laadi asiakkaalle selkeä vastaus lähdeaineiston perusteella.
Pidä sävy ystävällisenä ja ammattimaisena.
Älä lupaa mitään, mitä lähteissä ei sanota.
Jos asia vaatii ihmisen tarkistuksen, sano se selkeästi.
16.5 Päätöksenteon tuki
Tee tiivis analyysi tästä aiheesta lähdeaineiston perusteella. Anna:
• tärkeimmät faktat
• mahdolliset riskit
• avoimet kysymykset
• mitä pitäisi tarkistaa ennen päätöstäÄlä lisää ulkopuolista tietoa ilman erillistä merkintää.
16.6 RAG-vastauksen tarkistus
Tarkista edellinen vastauksesi.
Merkitse jokainen keskeinen väite lähteen mukaan.
Jos jokin väite ei perustu lähteeseen, poista se tai merkitse se oletukseksi.
Praktické zhrnutie
Jos prompt engineering opettaa kysymään tekoälyltä paremmin, RAG opettaa tekoälyn vastaamaan paremmista lähteistä. Se on ratkaiseva ero.
Tavallinen AI voi kuulostaa oikealta. RAG-pohjainen AI voi näyttää, mihin vastaus perustuu. Ja juuri se tekee siitä niin tärkeän tekniikan yrityksille, asiantuntijoille ja kaikille, jotka haluavat käyttää tekoälyä muutenkin kuin ideointiin.
Praktický tip: kun käytät RAG-pohjaista tekoälyassistenttia, pyydä sitä näyttämään lähteet ja kertomaan, jos vastausta ei löydy aineistosta. Se on pieni tapa rakentaa tekoälyn käyttöön isompi luottamus.
Lähteet
- What is Retrieval-Augmented Generation (RAG)? — Google Cloud
- What is RAG? Retrieval-Augmented Generation AI — Amazon Web Services
- What is retrieval-augmented generation (RAG)? — IBM Research
- Vertex AI RAG Engine overview — Google Cloud Documentation
- What Is Retrieval-Augmented Generation aka RAG — NVIDIA Blog
- 5 key features and benefits of retrieval augmented generation — Microsoft
- O que é RAG (retrieval-augmented generation)? — IBM
- Understanding Retrieval Augmented Generation — AWS Prescriptive Guidance
- Deeper insights into retrieval augmented generation — Google Research
- Evaluate the reliability of RAG applications — AWS Machine Learning Blog
- What is Agentic RAG? — IBM