
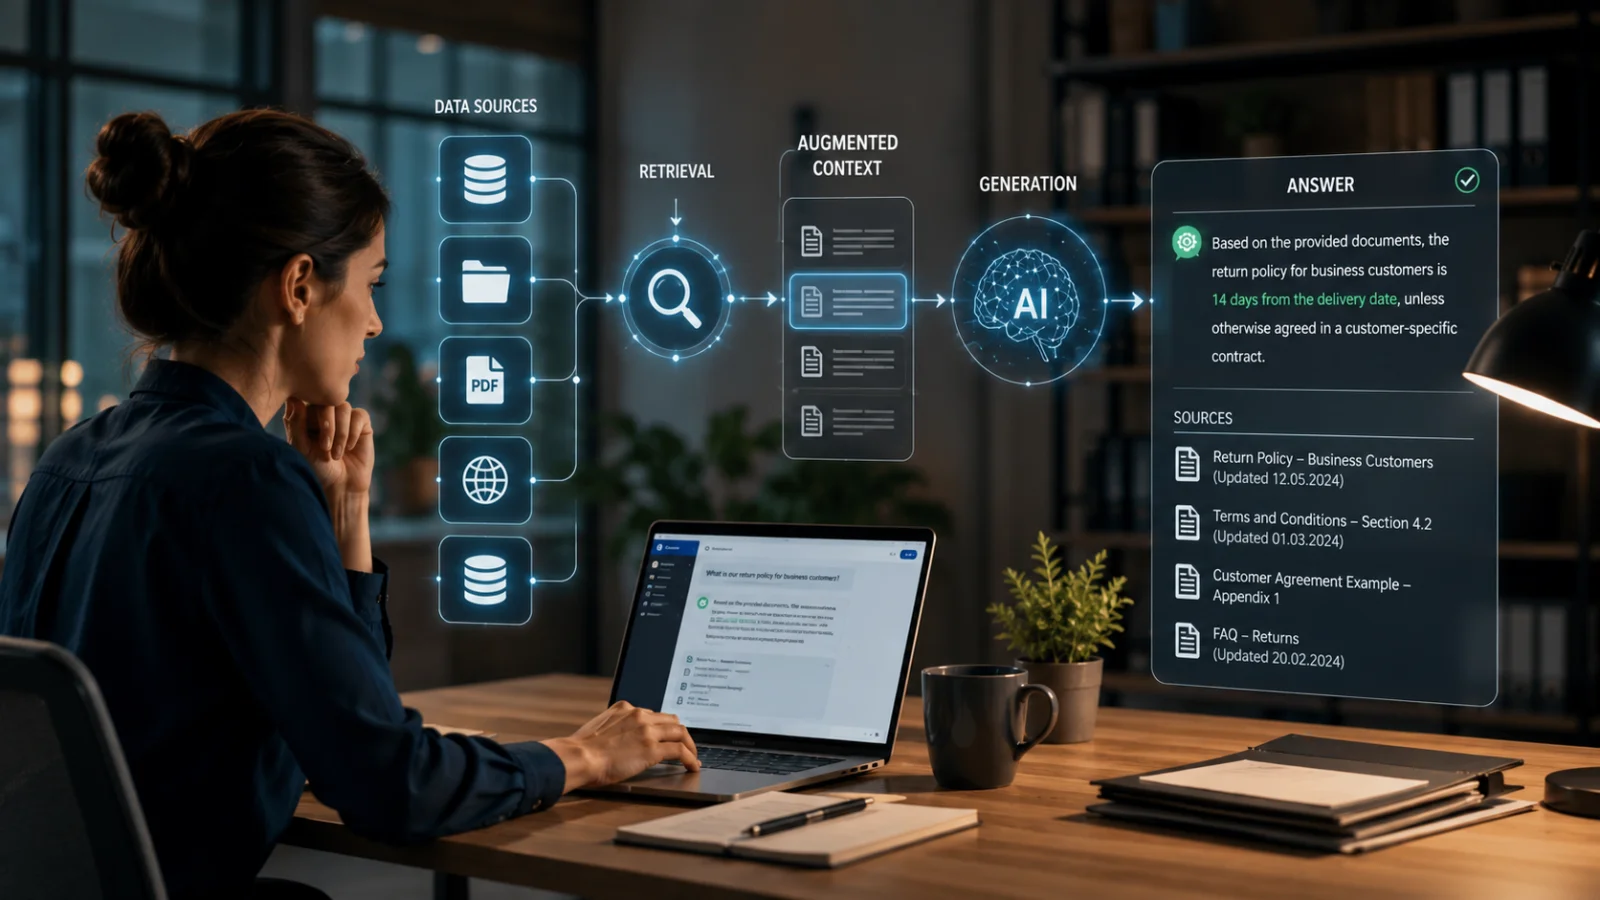
1. Įvadas: kodėl vien DI ne visada pakanka?
Dirbtinis intelektas geba rašyti stebėtinai sklandžiai.
Jis gali paaiškinti sudėtingą sąvoką, apibendrinti ataskaitą, parengti žinutės klientui juodraštį ar padėti formuoti strategiją. Tačiau daugelis jau pažįsta ir didžiausią jo silpnybę: DI gali atsakyti užtikrintai net tada, kai neturi pakankamai informacijos. Jis gali skambėti kaip ekspertas, nors iš tiesų tik spėja.
Darbe tai ypač rimta problema. Įmonėms iš DI paprastai reikia ne vien gražiai parašyto teksto. Reikia atsakymų, pagrįstų tikrais dokumentais, naujausia informacija, vidaus taisyklėmis, klientų duomenimis ar patikimais šaltiniais.
Šiam poreikiui patenkinti ir atsirado RAG, arba Retrieval-Augmented Generation.
Lietuviškai terminą būtų galima perteikti kaip „paieška papildytą generavimą“. Praktiškai tai technologija, kai DI atsako remdamasis ne vien savo atmintimi ar mokymo duomenimis: pirmiausia jis randa informaciją nurodytame šaltinyje ir pagal ją suformuluoja atsakymą.
Google Cloud RAG apibūdina kaip DI sistemą, jungiančią tradicinę informacijos paiešką, pavyzdžiui, paieškos sistemas ir duomenų bazes, su generatyvinių kalbos modelių gebėjimu kurti natūralią kalbą. Taip siekiama tikslesnių, aktualesnių ir konkrečiam naudotojo poreikiui geriau pritaikytų atsakymų.[1]
Paprasčiau tariant, RAG tarsi suteikia DI bibliotekos skaitytojo pažymėjimą. Užuot mėginęs atsakyti vien iš atminties, modelis prieš atsakydamas gali pasitikrinti aktualią informaciją.
2. Kas yra RAG?
RAG yra termino Retrieval-Augmented Generation trumpinys. Jį sudaro trys idėjos:
Retrieval – informacijos paieška
Sistema išoriniame šaltinyje ieško su naudotojo klausimu susijusios informacijos. Šaltinis gali būti, pavyzdžiui:
- įmonės vidinė žinių bazė
- produkto dokumentacija
- klientų aptarnavimo instrukcijos
- intranetas
- sutarčių šablonai
- tyrimų ataskaitos
- interneto svetainės
- duomenų bazė
- PDF dokumentai
- CRM arba ERP sistema
- dažniausiai užduodami klausimai
- mokomoji medžiaga
Augmented – papildyta
Rasta informacija įtraukiama į DI kontekstą. Taigi modeliui kartu su naudotojo klausimu pateikiama ir su juo susijusi medžiaga.
Generation – atsakymo generavimas
Kalbos modelis pagal rastą informaciją suformuluoja atsakymą naudotojui.
Amazon Web Services RAG apibrėžia kaip būdą optimizuoti didžiojo kalbos modelio rezultatą, suteikiant jam prieigą prie autoritetingos žinių bazės, kurios nebuvo mokymo duomenyse. Tai padeda modeliui teikti tikslesnius ir naudingesnius atsakymus.[2]
Svarbiausias skirtumas nuo įprasto DI atsakymo yra toks:
Be RAG modelis atsako remdamasis tuo, ką išmoko per mokymą ir ką naudotojas pateikė pokalbyje. Naudodamas RAG modelis papildomai gauna rastos, tikslesnės ir dažnai naujesnės informacijos būtent apie užduotą klausimą.
3. Kodėl atsirado RAG?
RAG atsirado sprendžiant vieną pagrindinių generatyvinio DI problemų: kalbos modeliai daro įspūdį, tačiau jų žinios savaime nėra naujausios, patikrintos ar pritaikytos konkrečiai organizacijai.
Didysis kalbos modelis gali turėti daug bendrųjų žinių. Jis gali paaiškinti, kas yra pinigų srautas, kaip veikia SaaS verslas ar kodėl svarbu išlaikyti klientus. Tačiau jis nebūtinai žino:
- kas parašyta būtent jūsų įmonės produkto instrukcijose
- koks yra naujausias kainynas
- kas nuspręsta praėjusios savaitės valdybos medžiagoje
- kokia šiandien galioja klientų aptarnavimo tvarka
- ką leidžia organizacijos informacijos saugumo politika
- kuo konkreti sutarties versija skiriasi nuo ankstesnės
- kas nurodyta naujausiose institucijos gairėse
IBM Research RAG vadina „atverstos knygos“ metodu: modelis nelaiko egzamino be medžiagos, o gali pagrįsti atsakymą išoriniais šaltiniais. IBM teigimu, du pagrindiniai RAG privalumai yra prieiga prie naujausių, patikimų faktų ir galimybė naudotojui matyti, kokiais šaltiniais paremtas atsakymas.[3]
Tai reikšmingas pokytis. Įprastas kalbos modelis primena sumanų plataus profilio specialistą, kuris daug prisimena, bet gali supainioti detales. RAG modelis – tas pats specialistas, tik priešais save turintis reikiamus dokumentus.
4. Kaip RAG veikia praktiškai?
RAG sistemos veikimą galima suskirstyti į penkis etapus.
1. Surenkama informacija
Pirmiausia į sistemą įkeliama medžiaga. Tai gali būti, pavyzdžiui:
- įmonės dokumentai
- interneto svetainių turinys
- instrukcijos
- žinių bazės straipsniai
- produktų aprašymai
- klientų aptarnavimo atsakymai
- vidinių procesų aprašymai
Šis etapas dažnai vadinamas duomenų įkėlimu, arba informacijos įtraukimu į sistemą.
2. Informacija suskaidoma dalimis
Ilgi dokumentai padalijami į mažesnes ištraukas, dažnai vadinamas fragmentais (chunks). Fragmentas – tinkamo dydžio teksto dalis, pavyzdžiui, kelios pastraipos ar dalis puslapio.
Tai svarbu, nes DI paprastai neverta dėl kiekvieno klausimo skaityti visos dokumentų bibliotekos. Jam reikia rasti būtent reikiamas vietas.
3. Informacija indeksuojama
Dokumentų fragmentai paverčiami forma, leidžiančia veiksmingai vykdyti paiešką. Dažnai naudojami vadinamieji įterpiniai (embeddings). Įterpinys yra skaitinė teksto išraiška: sistema tekstą paverčia matematiniu „piršto atspaudu“, padedančiu rasti panašaus turinio medžiagą.
Šie duomenys dažnai saugomi vektorinėje duomenų bazėje. Ji skirta rasti prasme panašų turinį, o ne vien tiksliai sutampančius žodžius.
4. Randama su naudotojo klausimu susijusi medžiaga
Naudotojui pateikus klausimą, sistema duomenų bazėje ieško su juo susijusių teksto fragmentų. Pavyzdžiui, jei klausiama:
„Kaip mūsų įmonės prekių grąžinimo tvarka taikoma verslo klientams?“
RAG sistema gali rasti grąžinimo sąlygas, klientų aptarnavimo instrukciją ir atitinkamą sutarties priedą.
5. Kalbos modelis suformuluoja šaltiniais pagrįstą atsakymą
Galiausiai kalbos modeliui pateikiamas naudotojo klausimas ir rasti teksto fragmentai. Jo užduotis – pagal juos suformuluoti aiškų atsakymą.
Google Cloud aprašomame Vertex AI RAG Engine procese laikomasi tos pačios logikos: duomenys įkeliami, konvertuojami ir suskaidomi, indeksuojami, randami pagal naudotojo klausimą ir pateikiami modeliui kaip kontekstas. Google pabrėžia, kad papildomas kontekstas padeda modeliui atsakyti tiksliau ir mažina haliucinacijų tikimybę.[4]
5. RAG paprastu palyginimu
Įsivaizduokime du specialistus.
Pirmasis specialistas sėdi posėdžių kambaryje be jokios medžiagos. Jis daug skaitė ir moka kalbėti įtikinamai. Paklaustas atsako iš atminties. Dažnai atsakymas būna geras. Tačiau paklaustas apie naujausią kainyną, tikslią sutarties sąlygą ar šios savaitės sprendimą jis gali suklysti.
Antrasis specialistas sėdi tame pačiame kambaryje, tačiau turi prieigą prie įmonės dokumentų, naujausių instrukcijų ir paieškos sistemos. Gavęs klausimą, jis pirmiausia randa reikiamą vietą ir tik tada atsako.
Tokia yra RAG esmė. Jis nepadaro DI neklystančio, tačiau suteikia jam geresnę darbo aplinką.
NVIDIA RAG lygina su teismo salės padėjėju: didysis kalbos modelis gali būti panašus į bendrą supratimą turintį teisėją, tačiau konkrečiai bylai reikia dokumentų, precedentų ir šaltinių. RAG veikia kaip „bibliotekininkas“, surandantis modeliui reikalingą medžiagą.[5]
Šis palyginimas taiklus, nes atskleidžia RAG esmę: geram atsakymui nepakanka vien sumanumo. Reikia tinkamos informacijos tinkamu metu.
6. Kaip RAG mažina haliucinacijas?
Haliucinacija vadinama situacija, kai DI pateikia įtikinamai skambančią, bet klaidingą ar išgalvotą informaciją. RAG mažina haliucinacijas, nes atsakymas susiejamas su rasta medžiaga.
Be RAG dirbtinis intelektas galėtų atsakyti taip:
„Jūsų įmonėje prekes galima grąžinti per 30 dienų.“
Naudojant RAG atsakymas gali būti paremtas dokumentu:
„Pagal sutarties sąlygas verslo klientai prekes gali grąžinti per 14 dienų, nebent individualioje kliento sutartyje numatyta kitaip.“
Skirtumas didžiulis. RAG ypač padeda trimis būdais.
1. Modelis gauna faktinį pagrindą
Gavusiam aktualų dokumentą modeliui nebereikia išgalvoti atsakymo nuo nulio.
2. Galima nurodyti atsakymo šaltinius
Gera RAG sistema parodo, kokiu dokumentu ar jo vieta paremtas atsakymas.
3. Naudotojas gali patikrinti teiginius
Šaltiniai leidžia lengviau patikrinti atsakymą. Naudotojas gali atverti pirminį dokumentą ir įsitikinti, ar atsakymas teisingas.
Microsoft kaip RAG privalumus pabrėžia mažesnę haliucinacijų tikimybę ir šaltinių skaidrumą. Bendrovės teigimu, RAG gali stiprinti pasitikėjimą ypač didelės rizikos srityse, tokiose kaip teisė, sveikatos priežiūra ir finansai, nes naudotojas gali patikrinti teiginių pagrindą.[6]
Tačiau svarbu atminti: RAG haliucinacijų visiškai nepašalina. Jis sumažina riziką, jei paieška randa tinkamą informaciją, o modelis ją tinkamai panaudoja.
7. Kaip RAG padeda atsakymams išlikti aktualiems?
Didysis kalbos modelis mokomas naudojant tam tikrą medžiagą iki konkretaus laiko, todėl jo vidinės žinios gali pasenti. RAG šią problemą sprendžia prijungdamas modelį prie išorinių informacijos šaltinių, kuriuos galima atnaujinti iš naujo nemokant viso modelio.
Įmonėms tai didžiulis privalumas.
Pasikeitus kainynui nereikia mokyti naujo kalbos modelio – pakanka atnaujinti kainyno dokumentą ar duomenų bazę. Pasikeitus klientų aptarnavimo tvarkai atnaujinama instrukcija, o pasikeitus teisės aktams – šaltinių medžiaga.
IBM prie RAG privalumų priskiria prieigą prie naujausių ir konkrečiai veiklos sričiai skirtų duomenų bei galimybę organizacijoms gerinti DI atsakymus be brangaus pakartotinio modelio mokymo.[7]
Čia atsiskleidžia praktinė RAG vertė. DI nebėra vien modelis, kuris „žino tai, ką žino“. Jis tampa sąsaja su nuolat atnaujinama žinių baze.
8. RAG naudojimas įmonėse ir organizacijose
RAG yra vienas svarbiausių būdų generatyvinį DI paversti iš tiesų naudingu įmonėms. Kodėl? Įmonės vertę paprastai kuria ne vien bendrosios žinios, bet ir jos pačios duomenys, procesai, klientai bei dokumentai.
RAG gali padėti, pavyzdžiui, šiose srityse:
Klientų aptarnavimas
Pokalbių robotas gali atsakyti į klientų klausimus remdamasis įmonės instrukcijomis, sutarties sąlygomis ir produktų informacija.
Pardavimas
Pardavėjas gali paklausti DI:
„Į ką vertėtų atkreipti dėmesį prieš susitikimą su šiuo klientu?“
RAG gali rasti CRM pastabas, ankstesnius pasiūlymus, pagalbos užklausas ir klientų segmento duomenis.
Personalo valdymas
Darbuotojas gali paklausti:
„Kaip mūsų įmonėje suteikiamos vaiko priežiūros atostogos?“
RAG gali rasti atsakymą personalo taisyklėse ir atitinkamo padalinio tvarkose.
Teisė ir atitiktis
Teisininkas ar atitikties komanda gali ieškoti sutarties nuostatų, reguliavimo gairių ir vidaus politikų.
Produktų kūrimas
Produkto komanda gali analizuoti klientų atsiliepimus, pagalbos užklausas ir produkto planų dokumentus.
Mokymas
Naujas darbuotojas gali klausti apie organizacijos darbo tvarką ir gauti atsakymus, paremtus įvadinio mokymo medžiaga.
Amazon Web Services RAG vadina praktišku ir veiksmingu būdu naudoti kalbos modelius įmonėse, nes modeliui pateikiami išoriniai duomenys, pavyzdžiui, įmonės vidaus dokumentai, todėl atsakymai geriau atitinka konkretų naudojimo atvejį.[8]
Tai ir yra verslo požiūriu svarbiausia RAG savybė: DI iš bendro pobūdžio tekstų kūrėjo tampa organizacijos žinių darbo sąsaja.
9. RAG DI asistentuose: ką svarbu žinoti naudotojui?
Praktinis patarimas:
RAG pagrįstas DI asistentas savo atsakymus grindžia naujausia informacija.
Naudotojui tai svarbus pažadas, tačiau jį reikia teisingai suprasti. RAG reiškia, kad DI asistentas, prieš suformuluodamas atsakymą, gali ieškoti jį pagrindžiančios informacijos apibrėžtuose šaltiniuose. Taip naudotojas gauna ne vien bendrojo kalbos modelio spėjimą, o atsakymą, pagrįstą sistemai prieinama žinių baze.
Praktikoje tai, pavyzdžiui, gali reikšti, kad RAG pagrįstas DI asistentas:
- ieško informacijos organizacijos dokumentuose
- naudoja naujausias instrukcijas
- pateikia nuorodas į šaltinius
- mažina išgalvotų atsakymų riziką
- gali atsakyti į konkrečiai organizacijai skirtus klausimus
- padeda naudotojui greičiau rasti reikiamą informaciją
Vis dėlto svarbu kalbėti atvirai: RAG savaime nepadaro jokios DI sistemos tobulos. RAG sprendimo rezultato kokybė priklauso, be kita ko, nuo to:
- kokybiška yra žinių bazė
- kiek naujausi yra šaltiniai
- ar paieška randa tinkamus dokumentus
- ar modelis tinkamai panaudoja rastą informaciją
- ar naudotojui parodomi šaltiniai
- kaip elgiamasi neaiškiais atvejais
Gera RAG sistema ne tik atsako. Ji padeda naudotojui suprasti, kuo atsakymas pagrįstas.
Todėl naudojant RAG pagrįstą DI asistentą verta paprašyti:
„Parodyk, kokiu šaltiniu paremtas šis atsakymas.“
Arba:
„Jei šaltiniuose nėra atsakymo, aiškiai tai pasakyk.“
Taip DI naudojimas tampa saugesnis ir skaidresnis.
10. RAG privalumai: kodėl apie jį tiek kalbama?
RAG greitai tapo viena svarbiausių generatyvinio DI technologijų, nes tiesiogiai sprendžia praktines DI naudojimo problemas.
10.1 Mažiau haliucinacijų
Kai atsakymas grindžiamas rasta medžiaga, modelis mažiau spėlioja.
10.2 Aktualesnė informacija
Žinių bazę galima atnaujinti iš naujo nemokant modelio.
10.3 Organizacijai būdingos žinios
RAG gali naudoti įmonės duomenis, kurių bendrasis kalbos modelis nežino.
10.4 Didesnis skaidrumas
Šaltinių nuorodos ir dokumentų saitai padeda naudotojui patikrinti atsakymą.
10.5 Ekonomiškumas
RAG gali būti paprastesnė ir pigesnė alternatyva nuolatiniam papildomam modelio mokymui ar mokymui iš naujo.
10.6 Greitesnė informacijos paieška
Naudotojui nereikia pačiam ieškoti tinkamo PDF failo, intraneto puslapio ar instrukcijos.
10.7 Geresnė klientų patirtis
Klientų aptarnavimo robotas gali atsakyti tiksliau, jei remiasi tikromis įmonės instrukcijomis.
Google Cloud teigimu, RAG sujungia organizacijos duomenis ir kalbos modelių kalbinius gebėjimus, todėl atsakymai gali būti tikslesni, aktualesni ir geriau atitikti naudotojo poreikius.[1]
Šiuo požiūriu RAG yra tarsi DI faktų patikra. Jis ne tik kuria tekstą – pirmiausia randa pagrindą, ant kurio tas tekstas statomas.
11. RAG ribotumai: kodėl tai nėra stebuklingas sprendimas?
RAG yra veiksmingas, bet ne stebuklingas. Jis gali suklysti įvairiais būdais.
11.1 Paieška gali rasti netinkamą informaciją
Jei sistema randa netinkamą dokumentą ar jo vietą, atsakymas gali būti klaidingas. Tai klasikinė RAG problema: tekstas sugeneruojamas gerai, tačiau retrieval, arba paieška, nepavyksta.
11.2 Informacija gali būti pasenusi
RAG padeda atsakymams išlikti aktualiems tik tada, kai atnaujinama žinių bazė. Jei joje yra sena instrukcija, DI gali atsakyti pagal pasenusią informaciją.
11.3 Dokumentai gali prieštarauti vieni kitiems
Jei organizacijoje yra trys tos pačios instrukcijos versijos, RAG gali rasti netinkamą arba jas supainioti.
11.4 Modelis gali neteisingai suprasti šaltinį
Net radęs tinkamą dokumentą kalbos modelis gali jį suprasti klaidingai arba pernelyg apibendrinti.
11.5 Šaltinio gali nepakakti atsakymui
Jei rastame kontekste nepakanka informacijos, modelis turėtų pasakyti „nežinau“. Ne visos sistemos tai daro tinkamai.
Google Research išskiria sufficient context, arba pakankamo konteksto, sąvoką. RAG sistemoje neužtenka, kad rasta informacija būtų bent kiek susijusi su klausimu. Jos turi pakakti teisingam atsakymui. Kai konteksto nepakanka, modelis turėtų pripažinti netikrumą, o ne išgalvoti atsakymą.[9]
Tai svarbi įžvalga. RAG nėra vien paieškos sistema ir DI. Esminis klausimas yra kokybė: ar rasta būtent tiek ir tokios informacijos, kad būtų galima atsakyti teisingai?
11.6 RAG gali sukelti klaidingą saugumo jausmą
Atsakymas su šaltinių nuorodomis atrodo patikimas. Tačiau nuoroda savaime negarantuoja, kad atsakymas teisingas. Šaltinis gali būti netinkamas, pasenęs ar klaidingai suprastas, todėl svarbius teiginius naudotojas vis tiek turi patikrinti.
12. Kaip sukurti gerą RAG sistemą?
Gerai RAG sistemai neužtenka kalbos modelį sujungti su dokumentų aplanku. Ją reikia kruopščiai suprojektuoti.
12.1 Kokybiška žinių bazė
Pirmiausia reikia atsakyti, kokia informacija pateikiama sistemai. Jei žinių bazė netvarkinga, pasenusi ar prieštaringa, nukentės ir atsakymai. Gera žinių bazė yra:
- aktuali
- atrinkta ir prižiūrima
- aiškios struktūros
- su versijų kontrole
- prižiūrima atsakingų asmenų
- su valdoma prieiga
12.2 Tinkamas dokumentų skaidymas
Dokumentus suskaidžius per smulkiai prarandamas kontekstas, o palikus per didelius fragmentus paieška gali tapti netiksli. Fragmentų dydžio pasirinkimas yra netikėtai svarbus techninis sprendimas: nuo jo priklauso, ar sistema ras reikiamą vietą.
12.3 Veiksmingas paieškos metodas
Vien paieškos pagal raktažodžius ne visada pakanka. Vektorinė paieška randa panašios prasmės turinį, net kai žodžiai tiksliai nesutampa. Dažnai geriausiai veikia hibridinė paieška, jungianti raktažodžių ir semantinę paiešką.
12.4 Šaltinių pateikimas
Naudotojas turi matyti, kuo pagrįstas atsakymas. Gerame RAG atsakyme gali būti:
- dokumento pavadinimas
- skirsnis arba puslapis
- nuoroda į šaltinį
- trumpas pagrindimas
- įspėjimas apie neapibrėžtumą, jei šaltinio nepakanka
12.5 Aiškios instrukcijos modeliui
Modeliui reikia aiškiai nurodyti, kaip elgtis. Pavyzdžiui:
„Atsakyk tik remdamasis pateiktais šaltiniais. Jei juose nėra atsakymo, aiškiai tai pasakyk.“
Taip sumažėja spėliojimo.
12.6 Vertinimas ir testavimas
RAG sistemą reikia testuoti tikrais klausimais. Amazon Web Services pabrėžia RAG programų patikimumo vertinimą: verta matuoti sistemos našumą, patikimumą ir galimą šališkumą.[10]
Testuojant verta klausti:
- Ar randamas tinkamas šaltinis?
- Ar atsakymas paremtas šaltiniu?
- Ar modelis neatsako, kai informacijos nėra?
- Ar naudotojas mato šaltinius?
- Ar atsakymas nėra pernelyg užtikrintas?
- Ar sistema tinkamai veikia skirtingoms naudotojų grupėms?
Geras RAG yra nuolatinis procesas, o ne vienkartinis projektas.
13. RAG ir papildomas modelio mokymas: kada rinktis kurį?
RAG dažnai painiojamas su papildomu modelio mokymu, tačiau tai skirtingi dalykai.
RAG metodas
RAG pateikia modeliui išorinę informaciją atsakymo metu. Jis tinka, kai:
- informacija dažnai keičiasi
- norima naudoti organizacijos dokumentus
- reikia parodyti šaltinius
- atsakymai turi išlikti aktualūs
- norima išvengti pakartotinio modelio mokymo
Papildomas modelio mokymas
Papildomas modelio mokymas reiškia, kad modelis toliau mokomas naudojant konkrečią medžiagą arba atlikti konkrečią užduotį. Jis tinka, kai:
- norima pakeisti modelio stilių
- norima išmokyti konkretaus atsakymo formato
- norima pagerinti konkrečios užduoties atlikimą
- duomenys yra gana pastovūs
- reikia konkretaus elgesio, o ne vien naujų žinių
Dažnai geriausia ne rinktis vieną iš dviejų, o juos derinti. Įmonė gali naudoti RAG aktualiai informacijai, o papildomą mokymą – konkrečiam atsakymo stiliui ar procesui išmokyti.
Tačiau jei problema yra ta, kad „modelis nežino mūsų naujausių instrukcijų“, RAG paprastai tinka geriau nei papildomas mokymas.
14. Ateitis: nuo RAG prie agentų ir išmaniųjų žinių darbo sistemų
RAG svarbus jau dabar, o jo reikšmė dar augs DI pereinant nuo paprastų pokalbių robotų prie agentų.
Agentas yra DI sistema, kuri ne tik atsako į klausimą, bet ir gali atlikti kelių etapų darbą: ieškoti informacijos, lyginti galimybes, naudoti įrankius, sudaryti planą ir galbūt net įvykdyti užduotis.
Tokiems agentams RAG yra bazinė infrastruktūra. Kad galėtų padėti darbuotojui, agentas turi žinoti:
- kas parašyta organizacijos instrukcijose
- ką klientas darė anksčiau
- kas vyksta sistemose
- kokių taisyklių reikia laikytis
- kokius dokumentus leidžiama naudoti
- kuo pagrįsta informacija
IBM apibūdina agentic RAG metodą, kuriame RAG sistema derinama su agento gebėjimais: sistema gali rasti informaciją išorinėje žinių bazėje ir panaudoti ją tikslesniems, konkrečiai sričiai pritaikytiems atsakymams, užuot rėmusis vien modelio mokymo duomenimis.[11]
Ateityje naudotojas RAG galbūt nebematys kaip atskiros technologijos. Jis tiesiog gaus geresnius atsakymus.
Naudotojas klausia, o sistema:
- randa tinkamus šaltinius
- įvertina, ar jų pakanka
- suformuluoja atsakymą
- parodo šaltinius
- nurodo neapibrėžtumą
- pasiūlo kitą veiksmą
Tai didelis žingsnis link DI, kuris ne tik skamba protingai, bet ir patikimiau veikia kasdieniame darbe.
15. Išvados: ką verta įsiminti?
RAG yra viena svarbiausių technologijų pritaikant generatyvinį DI realiame darbe. Ji sprendžia tris dideles problemas:
- DI žinios gali būti pasenusios
- DI nežino organizacijos duomenų
- DI gali įtikinamai haliucinuoti
RAG nepadaro DI tobulo, bet padaro jį naudingesnį, lengviau patikrinamą ir labiau susietą su realia informacija.
Svarbiausios išvados:
1. Naudodamas RAG DI pirmiausia ieško informacijos ir tik tada atsako
Tuo jis skiriasi nuo įprasto kalbos modelio atsakymo.
2. RAG mažina haliucinacijas, bet visiškai jų nepašalina
Netinkama paieška, pasenęs šaltinis ar klaidingas aiškinimas vis tiek gali lemti klaidą.
3. Šaltiniai yra vienas didžiausių RAG privalumų
Kai atsakymą galima susieti su dokumentu, naudotojas gali jį patikrinti.
4. Aktualumas priklauso nuo žinių bazės
RAG yra tik tiek geras, kiek geri jo naudojami duomenys.
5. Įmonėse RAG padeda panaudoti vidaus informaciją
Jis gali paversti intranetą, dokumentų aplanką ir instrukcijų bazę pokalbio sąsaja.
6. Naudojant RAG pagrįstą DI asistentą verta paprašyti parodyti šaltinius
Naudotojui verta paklausti: „Kuo pagrįstas šis atsakymas?“
7. Geriausias RAG kartais pasako: „Nežinau“
Patikima sistema neišgalvoja atsakymo, kai šaltinių nepakanka.
RAG esmė paprasta: DI veikia geriau, kai jam nereikia atsakyti vienam.
Kai modelis gauna tinkamą informaciją, šaltinius ir kontekstą, jis gali padėti kur kas labiau nei bendro pobūdžio pokalbių robotas. Tai jau ne vien teksto mašina, bet informacijos ieškotojas, aiškintojas ir darbo partneris – jei žmogus nepamiršta klausti, tikrinti ir vadovautis savo sprendimu.
16. Praktinės užklausos RAG sistemai
Toliau pateikiami užklausų šablonai, kuriuos galima naudoti su bet kuriuo RAG pagrįstu DI sprendimu.
16.1 Šaltiniais pagrįstas atsakymas
Atsakyk tik remdamasis turimais šaltiniais.
Jei šaltiniuose atsakymo nėra, pasakyk: „Turimoje medžiagoje atsakymo į šį klausimą nerandu.“
Atsakymo pabaigoje nurodyk šaltinius ar dokumentus, kuriais jis pagrįstas.
16.2 Neapibrėžtumo nustatymas
Atsakyk remdamasis šaltiniais. Atsakyme atskirk:
1) ką šaltiniai teigia užtikrintai
2) ką galima pagrįstai spręsti
3) ko negalima nustatyti iš pateiktos medžiagos
16.3 Dokumentų palyginimas
Palygink šiuos šaltinius.
Rask prieštaravimus, pasikartojimus ir vietas, kur naujesnis dokumentas, regis, pakeičia senesnį.
Nedaryk išvadų, kurių šaltiniai nepagrindžia.
16.4 Atsakymas klientui
Parenk klientui aiškų, šaltinių medžiaga pagrįstą atsakymą.
Rašyk draugiškai ir profesionaliai.
Nežadėk nieko, kas nenurodyta šaltiniuose.
Jei klausimą turi patikrinti žmogus, aiškiai tai nurodyk.
16.5 Pagalba priimant sprendimą
Remdamasis šaltinių medžiaga pateik glaustą temos analizę. Nurodyk:
• svarbiausius faktus
• galimas rizikas
• neatsakytus klausimus
• ką reikėtų patikrinti prieš priimant sprendimąNeįtrauk išorinės informacijos jos aiškiai nepažymėjęs.
16.6 RAG atsakymo patikra
Patikrink ankstesnį savo atsakymą.
Prie kiekvieno esminio teiginio nurodyk jo šaltinį.
Jei teiginys nėra pagrįstas šaltiniu, pašalink jį arba pažymėk kaip prielaidą.
Praktinė santrauka
Jei užklausų inžinerija moko geriau klausti DI, RAG leidžia DI atsakyti remiantis geresniais šaltiniais. Tai esminis skirtumas.
Įprastas DI gali skambėti teisingai. RAG pagrįstas DI gali parodyti, kuo atsakymas paremtas. Būtent todėl ši technologija tokia svarbi įmonėms, specialistams ir visiems, kurie nori DI naudoti ne vien idėjoms kurti.
Praktinis patarimas: naudodami RAG pagrįstą DI asistentą paprašykite parodyti šaltinius ir pasakyti, jei medžiagoje atsakymo nėra. Šis nedidelis įprotis padeda kurti didesnį pasitikėjimą DI.
Šaltiniai
- What is Retrieval-Augmented Generation (RAG)? — Google Cloud
- What is RAG? Retrieval-Augmented Generation AI — Amazon Web Services
- What is retrieval-augmented generation (RAG)? — IBM Research
- Vertex AI RAG Engine overview — Google Cloud Documentation
- What Is Retrieval-Augmented Generation aka RAG — NVIDIA Blog
- 5 key features and benefits of retrieval augmented generation — Microsoft
- O que é RAG (retrieval-augmented generation)? — IBM
- Understanding Retrieval Augmented Generation — AWS Prescriptive Guidance
- Deeper insights into retrieval augmented generation — Google Research
- Evaluate the reliability of RAG applications — AWS Machine Learning Blog
- What is Agentic RAG? — IBM