
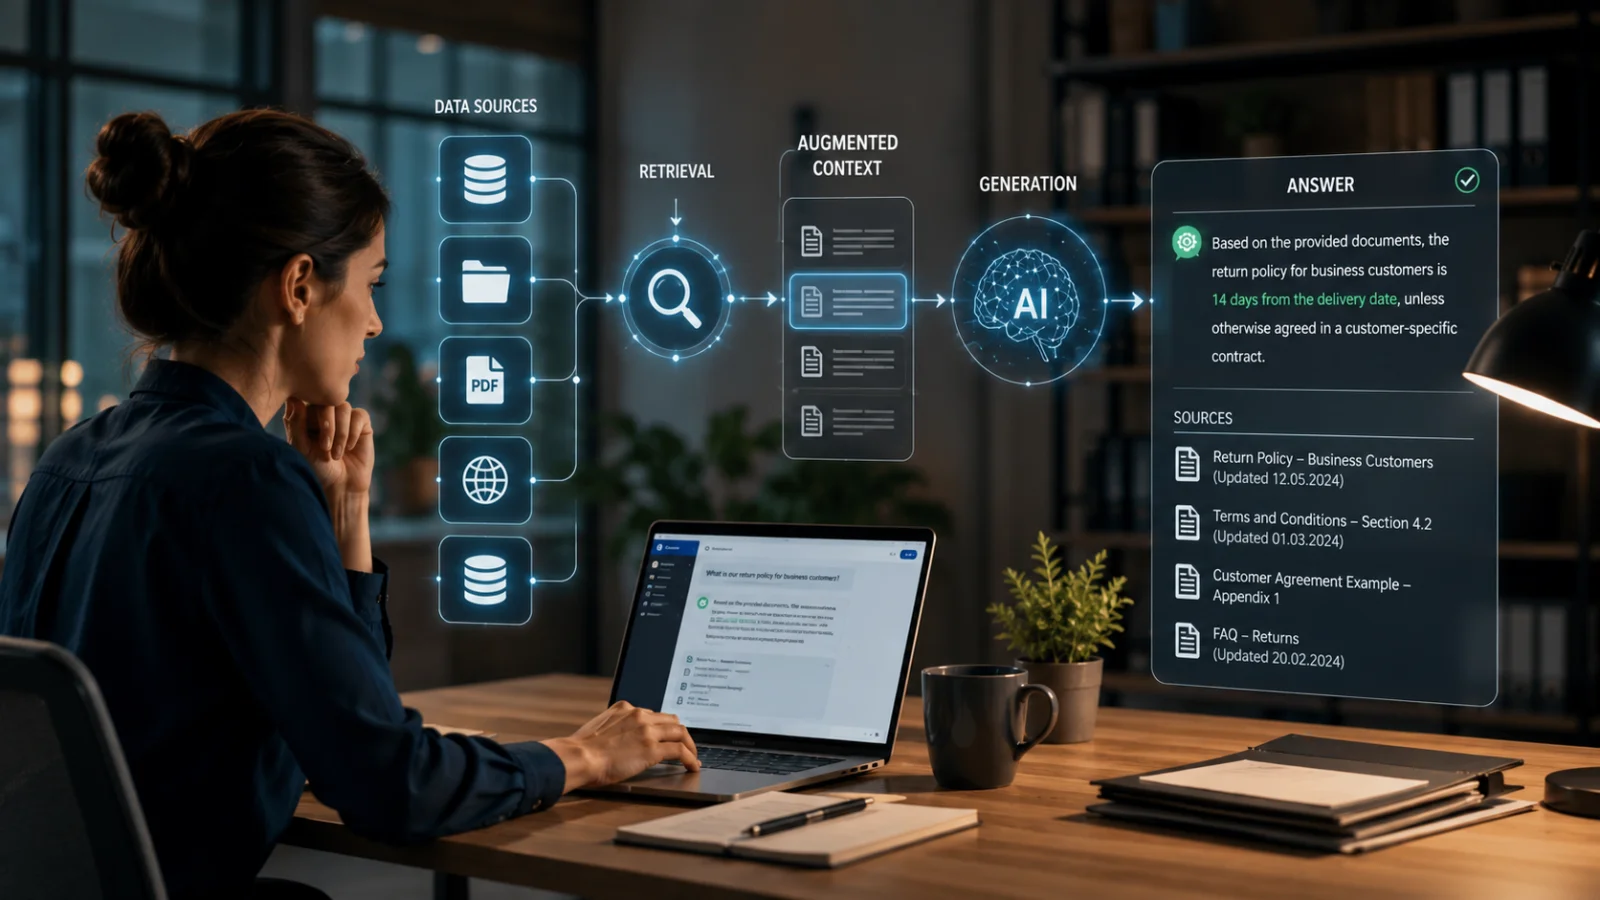
1. Въведение: защо само ИИ невинаги е достатъчен?
ИИ може да пише удивително гладко.
Той може да обясни сложно понятие, да обобщи доклад, да подготви чернова на съобщение до клиент или да помогне за оформянето на стратегия. Но мнозина вече познават и най-голямата му слабост: може да отговаря уверено дори когато няма достатъчно информация. Може да звучи като експерт, въпреки че гадае.
Това е особено сериозен проблем в работата. Фирмите обикновено не искат от ИИ само добре написан текст. Искат отговори, основани на действителни документи, актуална информация, вътрешни указания, клиентски данни или надеждни източници.
От тази потребност се появи RAG, или Retrieval-Augmented Generation.
На български терминът може да се преведе малко тромаво като „генериране, подпомогнато от извличане на информация“. На практика това е технология, при която ИИ не отговаря само въз основа на паметта си или на данните от обучението, а първо извлича информация от определен източник и изгражда отговора си върху нея.
Google Cloud описва RAG като рамка за ИИ, която съчетава традиционното извличане на информация, например чрез търсачки и бази данни, със способността на генеративните езикови модели да създават естествен език. Целта е отговорите да бъдат по-точни, по-актуални и по-добре съобразени с конкретните нужди на потребителя.[1]
Казано по-просто: RAG дава на ИИ читателска карта за библиотеката. Вместо да се опитва да отговаря само по памет, моделът получава възможност да провери необходимата информация, преди да отговори.
2. Какво означава RAG?
RAG е съкращение от Retrieval-Augmented Generation. То обединява три идеи:
Retrieval — извличане на информация
Системата търси във външен източник информация, свързана с въпроса на потребителя. Източникът може да бъде например:
- вътрешна база от знания на фирмата
- документация на продукта
- указания за обслужване на клиенти
- интранет
- образци на договори
- изследователски доклади
- уебсайтове
- база данни
- PDF документи
- CRM или ERP система
- често задавани въпроси
- учебни материали
Augmented — допълнено
Извлечената информация се добавя към контекста на ИИ. Така освен въпроса на потребителя моделът получава и материалите по темата.
Generation — създаване на отговора
Езиковият модел формулира отговор за потребителя въз основа на извлечената информация.
Amazon Web Services определя RAG като начин за оптимизиране на резултата от голям езиков модел чрез използване на авторитетна база от знания извън данните от обучението. Това помага на модела да създава по-точни и по-полезни отговори.[2]
Съществената разлика спрямо обикновения отговор на ИИ е следната:
Без RAG моделът отговаря въз основа на наученото при обучението и на предоставеното от потребителя в разговора. С RAG моделът получава допълнително извлечена, по-точна и често по-актуална информация за конкретния въпрос.
3. Защо се появи RAG?
RAG възникна като решение на един от основните проблеми на генеративния ИИ: езиковите модели са впечатляващи, но знанията им не са автоматично актуални, проверени или специфични за дадена организация.
Големият езиков модел може да има богата обща култура. Може да обясни какво е паричен поток, как работи SaaS бизнесът или защо задържането на клиенти е важно. Но може да не знае:
- какво пише в инструкциите за продуктите точно на вашата фирма
- коя е най-новата ценова листа
- какви решения са отразени в материалите на управителния съвет от миналата седмица
- какви са действащите днес правила за обслужване на клиенти
- какво разрешава политиката за информационна сигурност на организацията
- по какво дадена версия на договор се различава от предишната
- какво гласят актуалните указания на компетентния орган
IBM Research описва RAG като подход „с отворен учебник“: моделът не се явява на изпит без помощни материали, а може да използва външни източници в подкрепа на отговора си. Според IBM двете основни предимства на RAG са достъпът до актуални и надеждни факти и възможността потребителят да вижда на кои източници се основава отговорът.[3]
Това е голяма промяна. Традиционният езиков модел прилича на умен експерт с широки познания, който помни много, но може да обърка подробностите. Моделът с RAG е като същия експерт, но с правилните документи пред себе си.
4. Как работи RAG на практика?
Работата на една RAG система може да се опише в пет стъпки.
1. Информацията се събира
Първо в системата се въвеждат материали. Това могат да бъдат например:
- фирмени документи
- съдържание от уебсайтове
- инструкции
- статии от база от знания
- описания на продукти
- отговори на екипа за обслужване на клиенти
- описания на вътрешни процеси
Тази стъпка често се нарича зареждане на данни (data ingestion), тоест въвеждане на информацията в системата.
2. Информацията се разделя на части
Дългите документи се разделят на по-малки части, често наричани чанкове. Чанкът е текстов откъс с подходящ размер, например няколко абзаца или част от страница.
Това е важно, защото обикновено няма смисъл ИИ да чете цялата библиотека с документи за всеки въпрос. Той трябва да намира точно необходимите пасажи.
3. Информацията се индексира
Частите от документите се преобразуват във формат, който позволява ефективно търсене. Често се използват така наречените embeddings — векторни представяния. Това е числово представяне на текста: системата превръща текста в математически „отпечатък“, чрез който може да намира сходно съдържание.
Тези представяния често се съхраняват във векторна база данни. Тя е проектирана да намира съдържание със сходно значение, а не само точно съвпадащи думи.
4. Извличат се материали, свързани с въпроса на потребителя
Когато потребителят зададе въпрос, системата търси в базата данни свързаните с него текстови откъси. Ако въпросът е:
„Какви са правилата на нашата фирма за връщане на стоки от бизнес клиенти?“
RAG системата може да извлече условията за връщане, указанията за обслужване на клиенти и евентуално приложение към договора.
5. Езиковият модел формулира отговор въз основа на източниците
Накрая езиковият модел получава въпроса на потребителя и извлечените текстови откъси. Задачата му е да формулира ясен отговор въз основа на тях.
В описанието на Vertex AI RAG Engine на Google Cloud процесът следва същата логика: данните се зареждат в системата, преобразуват се и се разделят на части, индексират се, извличат се според въпроса на потребителя и се предоставят на модела като контекст. Google подчертава, че допълнителният контекст помага на модела да отговаря по-точно и да намалява халюцинациите.[4]
5. RAG чрез просто сравнение
Да си представим двама експерти.
Първият експерт седи в заседателна зала без никакви материали. Той е чел много и умее да говори убедително. Когато му зададат въпрос, отговаря по памет. Често отговорът е добър. Но ако го попитат за най-новата ценова листа, за конкретна клауза от договорните условия или за решение от тази седмица, може да сгреши.
Вторият експерт седи в същата зала, но има достъп до фирмените документи, актуалните указания и система за търсене. Когато му зададат въпрос, първо намира съответния пасаж и отговаря въз основа на него.
Това е идеята на RAG. Технологията не прави ИИ непогрешим. Но му осигурява по-добри условия за работа.
NVIDIA сравнява RAG с помощник в съдебната зала: големият езиков модел може да прилича на съдия с общи познания, но за конкретно дело са необходими документи, прецеденти и източници. RAG действа като „библиотекар“, който намира нужните на модела материали.[5]
Сравнението е точно, защото показва същността на RAG: добрият отговор не идва само от интелигентността. Той се ражда от правилната информация в правилния момент.
6. Как RAG намалява халюцинациите?
Халюцинация е ситуация, в която ИИ създава убедително звучаща, но невярна или измислена информация. RAG намалява халюцинациите, като обвързва отговора с извлечените материали.
Без RAG ИИ може да отговори така:
„Срокът за връщане във вашата фирма е 30 дни.“
С RAG отговорът може да се основава на документ:
„Според договорните условия срокът за връщане за бизнес клиенти е 14 дни, освен ако в индивидуалния договор с клиента не е уговорено друго.“
Разликата е огромна. RAG помага най-вече по три начина.
1. Моделът получава фактическа основа
Когато моделът получи подходящия документ, не е нужно да измисля отговора от нищото.
2. Отговорът може да бъде подкрепен с източници
Добрата RAG система показва на кой документ или пасаж се основава отговорът.
3. Потребителят може да провери твърденията
Източниците правят отговора по-лесен за проверка. Потребителят може да отвори оригиналния документ и да види дали отговорът е верен.
Microsoft посочва като предимства на RAG намаляването на халюцинациите и прозрачността на източниците. Според компанията RAG може да повиши доверието особено във високорискови области като правото, здравеопазването и финансите, защото потребителят може да провери на какво се основават твърденията.[6]
Но има важно уточнение: RAG не премахва халюцинациите напълно. Той намалява риска, ако търсенето намира правилната информация и моделът я използва правилно.
7. Защо RAG поддържа отговорите по-актуални?
Големият езиков модел е обучен с определени материали до определен момент. Вътрешните му знания могат да остареят. RAG решава този проблем, като свързва модела с външни източници на информация, които могат да се актуализират без повторно обучение на целия модел.
Това е огромно предимство за фирмите.
Ако ценовата листа се промени, няма нужда да се обучава нов езиков модел — актуализира се документът с цените или базата данни. Ако се променят указанията за обслужване на клиенти, актуализират се указанията. Ако законодателството се промени, актуализират се изходните материали.
IBM изтъква като предимства на RAG достъпа до актуални данни и данни за конкретния отрасъл, както и възможността организациите да подобряват отговорите на ИИ без скъпоструващо повторно обучение на модела.[7]
Тук се вижда практическата сила на RAG. ИИ вече не е просто модел, който „знае каквото знае“. Той се превръща в интерфейс към постоянно обновявана база от знания.
8. RAG във фирми и организации
Във фирмите RAG е един от най-важните начини генеративният ИИ да стане наистина полезен. Защо? Защото стойността на фирмата обикновено не е само в общите знания. Тя е в собствените ѝ данни, процеси, клиенти и документи.
RAG може да помогне например в следните случаи:
Обслужване на клиенти
Чатботът може да отговаря на клиентски въпроси въз основа на собствените указания, договорни условия и продуктови данни на фирмата.
Продажби
Търговецът може да попита ИИ:
„Какво е добре да знам за този клиент преди срещата?“
RAG може да извлече бележки от CRM, предишни оферти, заявки за поддръжка и данни за клиентския сегмент.
Човешки ресурси
Служителят може да попита:
„Как е уреден родителският отпуск в нашата фирма?“
RAG може да намери отговора в правилата за персонала и приложимите местни практики.
Правни въпроси и нормативно съответствие
Юристът или екипът по нормативно съответствие може да търси договорни клаузи, регулаторни указания и вътрешни политики.
Разработване на продукти
Продуктовият екип може да анализира обратна връзка от клиенти, заявки за поддръжка и документи с планове за развитие.
Обучение
Новият служител може да задава въпроси за начина на работа в организацията и да получава отговори въз основа на въвеждащите материали.
Amazon Web Services описва RAG като практичен и ефективен начин за използване на езикови модели във фирмите, защото предоставя на модела външни данни, например вътрешни фирмени документи, с които отговорите стават по-подходящи за конкретния случай.[8]
Това е бизнес същността на RAG: той превръща ИИ от универсален автор на текстове в интерфейс за работа със знанията на организацията.
9. RAG в ИИ асистентите: какво е добре да разбира потребителят?
Практическият съвет е:
ИИ асистентът, базиран на RAG, извлича актуална информация в подкрепа на отговорите си.
Това е важно обещание за потребителя, но то трябва да се разбира правилно. RAG означава, че ИИ асистентът може да извлече информация от определени източници в подкрепа на отговора си, преди да го формулира. Така потребителят получава не просто предположение на езиков модел с общо предназначение, а отговор, основан на базата от знания, с която системата разполага.
На практика това може да означава например, че ИИ асистентът, базиран на RAG:
- извлича информация от собствените документи на организацията
- използва актуални указания
- посочва изходните материали
- намалява риска от измислени отговори
- може да отговаря на въпроси, специфични за организацията
- помага на потребителя да намира правилната информация по-бързо
Все пак е важно да кажем честно: RAG не прави автоматично съвършена нито една ИИ система. При решение с RAG качеството на крайния резултат зависи, наред с другото, от това:
- колко качествена е базата от знания
- колко актуални са източниците
- дали търсенето намира правилните документи
- дали моделът умее да използва правилно извлечената информация
- дали източниците се показват на потребителя
- как се постъпва при несигурност
Добрата RAG система не просто отговаря. Тя помага на потребителя да види на какво се основава отговорът.
Затова при използване на ИИ асистент, базиран на RAG, е добре да поискате:
„Покажи на кой източник се основава този отговор.“
Или:
„Ако отговорът не се намира в изходните материали, кажи го направо.“
Това прави използването на ИИ по-безопасно и по-прозрачно.
10. Предимства на RAG: защо се говори толкова много за него?
RAG бързо се превърна в една от най-важните технологии в генеративния ИИ, защото се насочва пряко към практическите проблеми при използването му.
10.1 По-малко халюцинации
Когато отговорът се основава на извлечени материали, моделът гадае по-малко.
10.2 По-актуална информация
Базата от знания може да се актуализира без повторно обучение на модела.
10.3 Познания, специфични за организацията
RAG може да използва собствените данни на фирмата, които езиковият модел с общо предназначение не познава.
10.4 По-голяма прозрачност
Позоваванията на източници и връзките към документи помагат на потребителя да провери отговора.
10.5 Икономическа ефективност
RAG може да бъде по-леко решение от непрекъснатата фина настройка или повторното обучение на модела.
10.6 По-бързо намиране на информация
Потребителят не трябва ръчно да търси подходящия PDF, страница в интранет или инструкция.
10.7 По-добро клиентско преживяване
Ботът за обслужване на клиенти може да дава по-точни отговори, ако се основава на действителните указания на фирмата.
Google Cloud описва RAG като съчетание на собствените данни на организацията с езиковите способности на езиковите модели, благодарение на което отговорите могат да бъдат по-точни, по-актуални и по-подходящи за нуждите на потребителя.[1]
В този смисъл RAG е своеобразна проверка на ИИ спрямо действителността. Той не просто създава текст — първо намира основата, върху която да го изгради.
11. Ограничения на RAG: защо не е вълшебно решение?
RAG е ефективен, но не е магия. Може да се провали по много начини.
11.1 Търсенето може да намери грешна информация
Ако системата извлече грешния документ или грешния пасаж, отговорът може да е неверен. Това е класическият проблем при RAG: генерирането може да е добро, но retrieval, тоест извличането на информация, да се провали.
11.2 Информацията може да е остаряла
RAG поддържа отговорите актуални само ако базата от знания е актуална. Ако в базата данни има стара инструкция, ИИ може да отговори според нея.
11.3 Документите могат да си противоречат
Ако в организацията има три различни версии на една и съща инструкция, RAG може да извлече грешната или да ги смеси.
11.4 Моделът може да разтълкува източника погрешно
Дори да е намерен правилният документ, езиковият модел може да го разбере погрешно или да направи прекалено широки обобщения.
11.5 Източникът може да не е достатъчен за отговор
Ако извлеченият контекст не съдържа достатъчно информация, моделът трябва да каже „не знам“. Не всички системи се справят добре с това.
Google Research изтъква понятието sufficient context, тоест достатъчен контекст. Според тях при RAG системите не е достатъчно извлечената информация да е свързана по някакъв начин с въпроса. Тя трябва да е достатъчна, за да се отговори правилно. Ако контекстът не стига, моделът трябва да разпознае несигурността, вместо да измисля отговор.[9]
Това е важен извод. RAG не е просто търсачка плюс ИИ. Става дума за качество: намира ли се точно информацията, която е достатъчна за правилен отговор?
11.6 RAG може да създаде фалшиво чувство за сигурност
Когато в отговора има позовавания на източници, той изглежда надежден. Но позоваването не означава автоматично, че отговорът е правилен. Източникът може да е грешен, остарял или разтълкуван неправилно. Затова потребителят все пак трябва да проверява критично важните твърдения.
12. Как се изгражда добра RAG система?
Добрата RAG система не се получава просто чрез свързване на езиков модел с папка с документи. Тя изисква внимателно планиране.
12.1 Качествена база от знания
Първият въпрос е: каква информация се подава на системата? Ако базата от знания е разхвърляна, остаряла или противоречива, качеството на отговорите също страда. Добрата база от знания е:
- актуална
- внимателно подбрана
- ясно структурирана
- с управление на версиите
- поддържана от отговорни лица
- с контролирани права за достъп
12.2 Добро разделяне на документите на части
Ако документите се разделят на прекалено малки части, контекстът се губи. Ако частите са прекалено големи, търсенето може да стане неточно. Разделянето на части, или chunking, е изненадващо важен технически избор. То влияе на това дали системата ще намери правилния пасаж.
12.3 Ефективен метод за търсене
Само търсенето по ключови думи невинаги е достатъчно. Векторното търсене намира сходно по смисъл съдържание, дори думите да не съвпадат напълно. Често най-доброто решение е хибридното търсене, което съчетава търсене по ключови думи и семантично търсене.
12.4 Показване на източниците
Потребителят трябва да вижда на какво се основава отговорът. Добрият RAG отговор може да съдържа:
- името на документа
- раздела или страницата
- връзка към източника
- кратка обосновка
- уточнение за несигурността, ако източникът не е достатъчен
12.5 Ясни инструкции към модела
На модела трябва да се каже как да действа. Например:
„Отговаряй само въз основа на предоставените източници. Ако източниците не съдържат отговор, кажи го направо.“
Това намалява гадаенето.
12.6 Оценяване и тестване
RAG системата трябва да се тества с реални въпроси. Amazon Web Services подчертава оценяването на надеждността на RAG приложенията: системата трябва да се измерва, наред с другото, по отношение на производителността, надеждността и възможните пристрастия.[10]
При тестването е добре да се зададат следните въпроси:
- Намира ли се правилният източник?
- Основава ли се отговорът на източника?
- Въздържа ли се моделът от отговор, когато няма информация?
- Вижда ли потребителят източниците?
- Прекалено уверен ли е отговорът?
- Работи ли системата за различни групи потребители?
Добрият RAG е непрекъснат процес, а не еднократен проект.
13. RAG и фина настройка: кога е необходимо всяко от тях?
RAG често се бърка с фината настройка на модела. Това са различни неща.
RAG
RAG предоставя на модела външна информация в момента на отговора. Той е подходящ, когато:
- информацията се променя често
- трябва да се използват документите на организацията
- източниците трябва да се показват
- отговорите трябва да се поддържат актуални
- искаме да избегнем повторно обучение на модела
Фина настройка
Фината настройка означава допълнително обучение на модела с определени материали или за конкретна задача. Тя е подходяща, когато:
- искаме да променим стила на модела
- искаме да научим модела на определен формат на отговорите
- искаме да подобрим изпълнението на тясно определена задача
- данните са относително постоянни
- необходимо е специфично поведение, а не само нова информация
Често най-доброто решение не е да се избере само едното. Фирмата може да използва RAG за актуална информация, а фина настройка — например за усвояване на определен стил на отговаряне или процес.
Но ако проблемът е „моделът не познава най-новите ни указания“, RAG обикновено е по-естественото решение от фината настройка.
14. Бъдещето: от RAG към агенти и интелигентни системи за работа със знания
RAG е важен още сега, но значението му расте, докато ИИ преминава от обикновени чатботове към агенти.
Агентът е ИИ система, която не просто отговаря на въпрос, а може да изпълнява няколко стъпки: да извлича информация, да сравнява възможности, да използва инструменти, да създава план и дори да изпълнява задачи.
RAG е основна инфраструктура за такива агенти. Ако агентът трябва да помага на служител, той трябва да знае:
- какво гласят указанията на организацията
- какво е правил клиентът преди
- какво се случва в системите
- какви правила трябва да се спазват
- кои документи могат да се използват
- на какво се основава информацията
IBM описва подхода agentic RAG, при който RAG системата се съчетава с агентни способности: системата може да извлича информация от външна база от знания и да я използва за създаване на по-точни отговори за конкретния отрасъл, без моделът да разчита само на данните от обучението си.[11]
В бъдеще потребителят може да не вижда RAG като отделна технология. Ще го вижда под формата на по-добри отговори.
Потребителят задава въпрос, а системата:
- извлича правилните източници
- преценява дали са достатъчни
- формулира отговора
- показва източниците
- посочва несигурността
- предлага следващо действие
Това е голяма крачка към ИИ, който не само звучи умно, а работи по-надеждно като част от ежедневната работа.
15. Изводи: какво е добре да научим от това?
RAG е една от най-важните технологии при въвеждането на генеративния ИИ в реалната работа. Той решава три големи проблема:
- знанията на ИИ могат да са остарели
- ИИ не познава собствените данни на организацията
- ИИ може да халюцинира убедително
RAG не прави ИИ съвършен. Но го прави по-полезен, по-лесен за проверка и по-тясно свързан с действителната информация.
Най-важните изводи са следните:
1. RAG означава, че ИИ първо извлича информация и чак след това отговаря
Това го отличава от обикновения отговор на езиков модел.
2. RAG намалява халюцинациите, но не ги премахва напълно
Неправилното търсене, остарелият източник или лошото тълкуване все пак могат да доведат до грешка.
3. Източниците са голямото предимство на RAG
Когато отговорът може да се проследи до документ, потребителят може да го провери.
4. Актуалността зависи от базата от знания
RAG е толкова добър, колкото са добри данните, които използва.
5. Във фирмите RAG е ключът към използването на вътрешните знания
Той може да превърне интранета, папката с документи и хранилището с инструкции в разговорен интерфейс.
6. Когато използвате ИИ асистент, базиран на RAG, е добре да поискате да видите източниците
Добре е потребителят да попита: „На какво се основава този отговор?“
7. Най-добрият RAG понякога казва: „Не знам“
Надеждната система не измисля отговор, ако източниците не са достатъчни.
В крайна сметка същността на RAG е проста: ИИ става по-добър, когато не е принуден да отговаря сам.
Когато моделът разполага с правилната информация, правилните източници и правилния контекст, той може да помогне много повече от обикновен чатбот с общо предназначение. Вече не е просто машина за текст. Той търси информация, тълкува я и е партньор в работата — стига човекът да не забравя да пита, да проверява и да използва собствената си преценка.
16. Практически промптове за работа с RAG система
По-долу ще намерите шаблони за промптове, които можете да използвате с всяко решение с ИИ, базирано на RAG.
16.1 Отговор, основан на източници
Отговорете само въз основа на наличните източници.
Ако отговорът не се намира в източниците, кажете: „Не намирам отговор на този въпрос в наличните материали.“
В края на отговора добавете източниците или документите, на които той се основава.
16.2 Разпознаване на несигурността
Отговорете на въпроса въз основа на източниците. Разграничете в отговора:
1) какво източниците потвърждават със сигурност
2) какви изводи могат да се направят
3) какво не може да се заключи от предоставените материали
16.3 Сравняване на документи
Сравнете тези източници помежду им.
Открийте противоречията, припокриванията и местата, където по-нов документ изглежда заменя по-стар.
Не правете изводи, които не се подкрепят от източниците.
16.4 Отговор за обслужване на клиенти
Съставете ясен отговор за клиента въз основа на изходните материали.
Поддържайте любезен и професионален тон.
Не обещавайте нищо, което не е посочено в източниците.
Ако въпросът изисква проверка от човек, посочете го ясно.
16.5 Подкрепа при вземане на решения
Направете кратък анализ по тази тема въз основа на изходните материали. Посочете:
• най-важните факти
• възможни рискове
• открити въпроси
• какво трябва да се провери преди вземането на решениеНе добавяйте външна информация, без изрично да я обозначите.
16.6 Проверка на отговор, генериран с RAG
Проверете предишния си отговор.
Посочете източника на всяко основно твърдение.
Ако някое твърдение не се основава на източник, премахнете го или го обозначете като предположение.
Практическо обобщение
Ако промпт инженерството ни учи да задаваме по-добри въпроси на ИИ, RAG учи ИИ да отговаря въз основа на по-добри източници. Това е решаващата разлика.
Обикновеният ИИ може да звучи убедително. ИИ, базиран на RAG, може да покаже на какво се основава отговорът му. Именно това го прави толкова важна технология за компаниите, специалистите и всички, които искат да използват изкуствения интелект и за нещо повече от генериране на идеи.
Практически съвет: когато използвате асистент с ИИ, базиран на RAG, помолете го да показва източниците и да посочва, когато отговорът не се намира в материалите. Това е малка стъпка към по-голямо доверие при използването на изкуствен интелект.
Източници
- What is Retrieval-Augmented Generation (RAG)? — Google Cloud
- What is RAG? Retrieval-Augmented Generation AI — Amazon Web Services
- What is retrieval-augmented generation (RAG)? — IBM Research
- Vertex AI RAG Engine overview — Google Cloud Documentation
- What Is Retrieval-Augmented Generation aka RAG — NVIDIA Blog
- 5 key features and benefits of retrieval augmented generation — Microsoft
- O que é RAG (retrieval-augmented generation)? — IBM
- Understanding Retrieval Augmented Generation — AWS Prescriptive Guidance
- Deeper insights into retrieval augmented generation — Google Research
- Evaluate the reliability of RAG applications — AWS Machine Learning Blog
- What is Agentic RAG? — IBM