
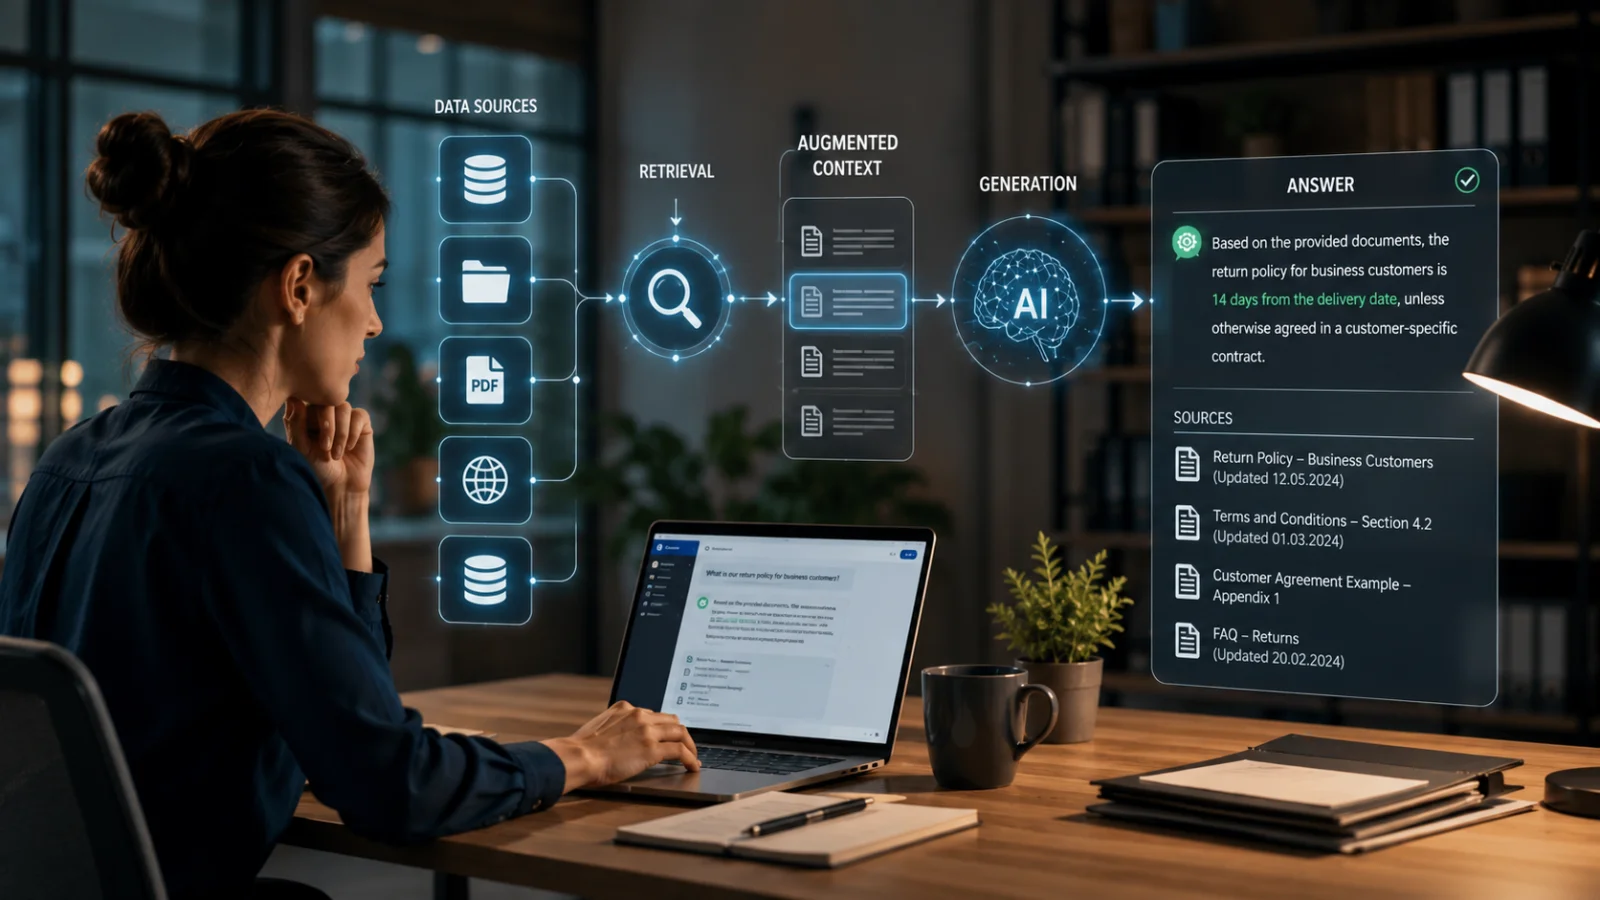
1. Introducción: ¿por qué la IA por sí sola no siempre basta?
La IA escribe con una fluidez asombrosa.
Puede explicar un concepto complejo, resumir un informe, redactar el borrador de un mensaje a un cliente o ayudar a dar forma a una estrategia. Pero al mismo tiempo su mayor debilidad ya le resulta familiar a mucha gente: puede responder con total seguridad incluso cuando no tiene información suficiente. Puede sonar a experta aunque esté adivinando.
En el mundo laboral este es un problema especialmente grave. En las empresas normalmente no se quiere de la IA solo un texto bonito. Se quieren respuestas basadas en documentos reales, información actualizada, instrucciones internas, datos de clientes o fuentes fiables.
Para responder a esa necesidad nació RAG, es decir, Retrieval-Augmented Generation.
En español podría traducirse, con cierta torpeza, como “generación aumentada por recuperación”. En la práctica es una técnica en la que la IA no responde apoyándose solo en su memoria o en sus datos de entrenamiento, sino que primero busca información en una fuente definida y construye la respuesta a partir de ella.
Google Cloud describe RAG como un marco de IA que combina la recuperación de información tradicional, como los sistemas de búsqueda y las bases de datos, con la capacidad de los modelos de lenguaje generativos para producir lenguaje natural. El objetivo es que las respuestas sean más precisas, más actuales y se ajusten mejor a la necesidad concreta del usuario.[1]
Dicho de forma más sencilla: RAG le da a la IA un carné de biblioteca. En lugar de responder solo de memoria, el modelo puede consultar la información relevante antes de contestar.
2. ¿Qué significa RAG?
RAG son las siglas de Retrieval-Augmented Generation. Se compone de tres ideas:
Retrieval — recuperación de información
El sistema busca en una fuente externa la información relacionada con la pregunta del usuario. La fuente puede ser, por ejemplo:
- la base de conocimiento interna de la empresa
- documentación de producto
- guías de atención al cliente
- intranet
- plantillas de contratos
- informes de investigación
- páginas web
- una base de datos
- Documentos PDF
- un sistema CRM o ERP
- preguntas frecuentes
- materiales de formación
Augmented — aumentada
La información recuperada se añade al contexto de la IA. Además de la pregunta del usuario, el modelo recibe el material relacionado con el asunto.
Generation — producir la respuesta
El modelo de lenguaje formula la respuesta al usuario a partir de la información recuperada.
Amazon Web Services define RAG como una forma de optimizar la salida de un gran modelo de lenguaje haciendo que consulte una base de conocimiento fiable ajena a sus datos de entrenamiento. Así el modelo genera respuestas más precisas y más útiles.[2]
La diferencia importante respecto a una respuesta de IA normal es esta:
Sin RAG, el modelo responde a partir de lo que aprendió durante el entrenamiento y de lo que el usuario le da en la conversación. Con RAG recibe además información recuperada, más precisa y a menudo más actual, sobre la pregunta concreta.
3. ¿Por qué nació RAG?
RAG nació para resolver un problema de fondo de la IA generativa: los modelos de lenguaje son impresionantes, pero su conocimiento no está automáticamente actualizado, verificado ni adaptado a una organización concreta.
Un modelo de lenguaje grande puede saber muchas cosas generales. Puede explicar qué es el flujo de caja, cómo funciona un negocio SaaS o por qué importa la retención de clientes. Pero puede que no sepa:
- qué dicen las instrucciones de producto de tu propia empresa
- cuál es la lista de precios más reciente
- qué se decidió en el material del consejo de administración de la semana pasada
- cuál es la práctica de atención al cliente vigente hoy
- qué permite la política de seguridad de la información de la organización
- en qué se diferencia una versión concreta del contrato respecto de la anterior
- qué dicen las directrices oficiales vigentes
IBM Research describe RAG como un enfoque ”de libro abierto”: el modelo no se examina a libro cerrado, sino que puede usar fuentes externas para respaldar su respuesta. Según IBM, las dos ventajas centrales de RAG son el acceso a datos actuales y fiables y el hecho de que el usuario pueda ver en qué fuentes se basa la respuesta.[3]
Es un cambio grande. Un modelo de lenguaje tradicional es como un generalista brillante que recuerda mucho pero puede confundir detalles. Un modelo con RAG es ese mismo experto con los documentos correctos delante.
4. ¿Cómo funciona RAG en la práctica?
El funcionamiento de un sistema RAG puede describirse en cinco pasos.
1. Se recopila la información
Primero se incorporan contenidos al sistema. Pueden ser, por ejemplo:
- documentos de la empresa
- contenido de páginas web
- instrucciones
- artículos de la base de conocimiento
- descripciones de producto
- respuestas de atención al cliente
- descripciones de procesos internos
Esta fase se suele llamar ingesta de datos, es decir, la incorporación de la información al sistema.
2. La información se divide en fragmentos
Los documentos largos se dividen en partes más pequeñas que suelen llamarse chunks. Un chunk es un fragmento de texto de tamaño manejable, por ejemplo unos párrafos o parte de una página.
Esto es importante porque normalmente no conviene que la IA lea toda la biblioteca de documentos para cada pregunta. Tiene que encontrar exactamente los pasajes correctos.
3. La información se indexa
Los fragmentos de documento se convierten a un formato que permite buscarlos con eficacia. A menudo se recurre a los llamados embeddings. Un embedding es la representación numérica de un texto: el sistema crea una ”huella dactilar” matemática con la que se pueden encontrar contenidos parecidos.
Estas representaciones suelen almacenarse en una base de datos vectorial. Es una base de datos diseñada para encontrar contenidos de significado parecido, no solo las mismas palabras exactas.
4. Se recupera el material relevante para la pregunta del usuario
Cuando el usuario pregunta algo, el sistema busca en la base de datos los fragmentos de texto relacionados. Si la pregunta es:
«¿Cómo funciona nuestra política de devoluciones para los clientes empresariales?»
Un sistema RAG puede recuperar las condiciones de devolución, la guía de atención al cliente y un posible anexo del contrato.
5. El modelo de lenguaje elabora la respuesta a partir de las fuentes
Por último, el modelo de lenguaje recibe la pregunta del usuario y los fragmentos de texto recuperados. Su tarea es formular una respuesta clara a partir de ellos.
En la descripción de Vertex AI RAG Engine de Google Cloud, el proceso sigue la misma lógica: los datos se incorporan al sistema, se transforman y se dividen, se indexan, se recuperan en relación con la pregunta del usuario y se entregan al modelo como contexto. Google subraya que ese contexto adicional ayuda al modelo a responder con más precisión y reduce las alucinaciones.[4]
5. RAG explicado con una comparación sencilla
Imaginemos dos expertos.
El primer experto está sentado en una sala de reuniones sin ningún material. Ha leído mucho y habla de forma convincente. Cuando le preguntas algo, responde de memoria. A menudo la respuesta es buena. Pero si le preguntas por la última lista de precios, por el punto exacto de una cláusula o por una decisión de esta semana, puede equivocarse.
El segundo experto está en la misma sala, pero tiene acceso a los documentos de la empresa, a las instrucciones actualizadas y a un sistema de búsqueda. Cuando le preguntas algo, primero busca el punto exacto y responde a partir de él.
Esa es la idea de RAG. No hace que la IA sea infalible. Pero le da un escritorio de trabajo mejor.
NVIDIA compara RAG con un ayudante en la sala del tribunal: un gran modelo de lenguaje puede ser como un juez con una comprensión general, pero para un caso concreto hacen falta documentos, precedentes y fuentes. RAG hace de ”bibliotecario” y recupera para el modelo el material necesario.[5]
La comparación es acertada porque revela el núcleo de RAG: una buena respuesta no nace solo de la inteligencia. Nace de la información correcta en el momento correcto.
6. ¿Cómo reduce RAG las alucinaciones?
Se habla de alucinación cuando la IA produce información que suena creíble pero es errónea o inventada. RAG reduce las alucinaciones porque ancla la respuesta al material recuperado.
Sin RAG, la IA puede responder así:
«En vuestra empresa el plazo de devolución es de 30 días.»
Con RAG la respuesta puede apoyarse en un documento:
«Según las condiciones del contrato, el plazo de devolución para los clientes empresariales es de 14 días, salvo que se haya acordado otra cosa en el contrato específico con el cliente.»
La diferencia es enorme. RAG ayuda sobre todo de tres maneras.
1. El modelo recibe una base de hechos
Cuando el modelo recibe el documento pertinente, no tiene que inventarse la respuesta de la nada.
2. La respuesta se puede respaldar con fuentes
Un buen sistema RAG muestra en qué documento o en qué punto se basa la respuesta.
3. El usuario puede comprobar las afirmaciones
Las fuentes hacen que la respuesta sea más auditable. El usuario puede abrir el documento original y comprobar si la respuesta es correcta.
Microsoft destaca como ventajas de RAG la reducción de las alucinaciones y la transparencia de las fuentes. Según la compañía, RAG puede aumentar la confianza sobre todo en sectores de alto riesgo, como el jurídico, el sanitario y el financiero, porque el usuario puede comprobar en qué se basan las afirmaciones.[6]
Pero hay un matiz importante: RAG no elimina del todo las alucinaciones. Reduce el riesgo si la búsqueda encuentra la información correcta y el modelo la usa bien.
7. ¿Por qué RAG mantiene las respuestas más al día?
Un modelo de lenguaje grande se ha entrenado con un material determinado hasta una fecha determinada. Su conocimiento interno puede quedar obsoleto. RAG aborda ese problema conectando el modelo a fuentes externas que pueden actualizarse sin reentrenar el modelo entero.
Para las empresas es una ventaja enorme.
Si cambia la lista de precios, no hace falta entrenar un modelo de lenguaje nuevo — se actualiza el documento de precios o la base de datos. Si cambia una guía de atención al cliente, se actualiza la guía. Si cambia la legislación, se actualiza el material de origen.
IBM destaca como ventajas de RAG el acceso a datos actualizados y específicos de cada sector, y el hecho de que las organizaciones puedan mejorar las respuestas de la IA sin un costoso reentrenamiento del modelo.[7]
Aquí se ve la fuerza práctica de RAG. La IA deja de ser solo un modelo que “sabe lo que sabe”. Se convierte en una interfaz hacia una base de conocimiento viva.
8. RAG en empresas y organizaciones
En las empresas, RAG es una de las formas más importantes de hacer que la IA generativa resulte de verdad útil. ¿Por qué? Porque el valor de una empresa no suele estar en el conocimiento general. Está en sus propios datos, sus procesos, sus clientes y sus documentos.
RAG puede ayudar, por ejemplo, en estos casos de uso:
Atención al cliente
Un chatbot puede responder a las preguntas de los clientes basándose en las guías, las condiciones contractuales y la información de producto de la propia empresa.
Ventas
Un comercial puede preguntar a la IA:
«¿Qué conviene tener en cuenta de este cliente antes de la reunión?»
RAG puede recuperar notas del CRM, ofertas anteriores, tickets de soporte e información sobre el segmento de cliente.
RR. HH.
Alguien del equipo puede preguntar:
«¿Cómo funciona el permiso parental en nuestra empresa?»
RAG puede buscar la respuesta en las instrucciones de personal y en las posibles prácticas locales.
Asuntos legales y compliance
El equipo jurídico o de compliance puede buscar cláusulas de contratos, guías regulatorias y políticas internas.
Desarrollo de producto
El equipo de producto puede analizar el feedback de clientes, las peticiones de soporte y los documentos de roadmap.
Formación
Una persona recién incorporada puede preguntar por las formas de trabajar de la organización y obtener respuestas basadas en los materiales de incorporación.
Amazon Web Services describe RAG como una forma pragmática y eficaz de usar modelos de lenguaje en las empresas, porque aporta al modelo datos externos, como los documentos internos de la empresa, con los que las respuestas se ajustan mejor a un caso de uso concreto.[8]
Este es el núcleo de negocio de RAG: convierte la IA de redactora generalista en la interfaz del trabajo del conocimiento de la organización.
9. RAG en los asistentes de IA: ¿qué conviene entender como usuario?
El consejo práctico es este:
Un asistente de IA basado en RAG fundamenta sus respuestas en información actualizada.
Para el usuario es una promesa importante, pero conviene entenderla bien. RAG significa que el asistente de IA puede buscar información en fuentes definidas antes de formular su respuesta. Así el usuario no recibe la simple suposición de un modelo de lenguaje general, sino una respuesta basada en la base de conocimiento de la que dispone el sistema.
En la práctica, esto puede significar, por ejemplo, que un asistente de IA basado en RAG:
- recupera información de los documentos propios de la organización
- usa instrucciones actualizadas
- remite al material de origen
- reduce el riesgo de respuestas inventadas
- puede responder a preguntas propias de la organización
- ayuda al usuario a encontrar antes la información correcta
Aun así, hay que decirlo con honestidad: RAG no convierte automáticamente en perfecto a ningún sistema de IA. En una solución RAG, la calidad del resultado depende, entre otras cosas, de:
- qué calidad tiene la base de conocimiento
- hasta qué punto están actualizadas las fuentes
- si la búsqueda encuentra los documentos correctos
- si el modelo sabe usar correctamente la información recuperada
- si se muestran las fuentes al usuario
- cómo se actúa en las situaciones de incertidumbre
Un buen sistema RAG no solo responde. Ayuda al usuario a ver en qué se basa la respuesta.
Por eso, al usar un asistente de IA basado en RAG conviene pedir:
«Muestra en qué fuente se basa esta respuesta.»
O bien:
«Si la respuesta no está en el material de origen, dilo claramente.»
Esto hace que el uso de la IA sea más seguro y más transparente.
10. Ventajas de RAG: ¿por qué se habla tanto de esto?
RAG se ha convertido rápidamente en una de las técnicas más importantes de la IA generativa, porque responde directamente a sus puntos débiles en la práctica.
10.1 Menos alucinaciones
Cuando la respuesta se basa en material recuperado, el modelo adivina menos.
10.2 Información más actual
La base de conocimiento se puede actualizar sin reentrenar el modelo.
10.3 Conocimiento propio de la organización
RAG puede aprovechar los datos propios de la empresa, que un modelo de lenguaje general no conoce.
10.4 Más transparencia
Las referencias a fuentes y los enlaces a documentos ayudan al usuario a comprobar la respuesta.
10.5 Eficiencia en costes
RAG puede ser una alternativa más ligera que el fine-tuning continuo o el reentrenamiento del modelo.
10.6 Encontrar la información más rápido
El usuario no tiene que buscar a mano el PDF, la página de la intranet o la instrucción que necesita.
10.7 Mejor experiencia de cliente
Un bot de atención al cliente puede dar respuestas más precisas si se apoya en las instrucciones reales de la empresa.
Google Cloud describe RAG como la unión entre los datos propios de una organización y las capacidades lingüísticas de los modelos de lenguaje, de modo que las respuestas pueden ser más precisas, más actuales y más relevantes para el usuario.[1]
En ese sentido, RAG es una especie de contraste con la realidad para la IA. No se limita a producir texto — primero busca el terreno sobre el que se construye ese texto.
11. Los límites de RAG: ¿por qué no es una solución mágica?
RAG es potente, pero no es magia. Puede fallar de muchas maneras.
11.1 La búsqueda puede encontrar información equivocada
Si el sistema recupera el documento equivocado o el punto equivocado, la respuesta puede salir mal. Es el problema clásico de RAG: la generación puede ser buena, pero el retrieval, es decir, la recuperación, falla.
11.2 La información puede estar desactualizada
RAG mantiene las respuestas al día solo si la base de conocimiento está al día. Si en ella hay una instrucción antigua, la IA puede responder según esa instrucción antigua.
11.3 Los documentos pueden contradecirse
Si en la organización hay tres versiones distintas de la misma instrucción, RAG puede recuperar la equivocada o mezclarlas.
11.4 El modelo puede interpretar mal la fuente
Aunque se encuentre el documento correcto, el modelo de lenguaje puede entenderlo mal o generalizar demasiado.
11.5 Puede que la fuente no baste para responder
Si el contexto recuperado no contiene información suficiente, el modelo debería decir ”no lo sé”. No todos los sistemas lo hacen bien.
Google Research ha puesto sobre la mesa el concepto de sufficient context, es decir, contexto suficiente. Según esta idea, en los sistemas RAG no basta con que la información recuperada sea de algún modo relevante. Tiene que ser suficiente para responder correctamente a la pregunta. Si el contexto no basta, el modelo debería reconocer la incertidumbre en lugar de inventarse la respuesta.[9]
Esta es una observación importante. RAG no es solo un buscador más una IA. Es una cuestión de calidad: ¿aparece justo la información que basta para dar la respuesta correcta?
11.6 RAG puede dar una falsa sensación de seguridad
Cuando una respuesta incluye referencias a fuentes, parece fiable. Pero una referencia no significa automáticamente que la respuesta sea correcta: la fuente puede ser errónea, estar desfasada o haberse interpretado mal. Por eso el usuario debe seguir comprobando las afirmaciones críticas.
12. ¿Cómo se construye un buen sistema RAG?
Un buen sistema RAG no nace solo de juntar un modelo de lenguaje con una carpeta de documentos. Exige un diseño cuidadoso.
12.1 Una base de conocimiento de calidad
La primera pregunta es: ¿qué información se le da al sistema? Si la base de conocimiento está desordenada, obsoleta o llena de contradicciones, las respuestas también lo estarán. Una buena base de conocimiento es:
- actualizada
- curada
- bien estructurado
- versionada
- mantenida por responsables designados
- con permisos de acceso controlados
12.2 Una buena división de los documentos
Si los documentos se trocean demasiado, se pierde el contexto. Si los trozos son demasiado grandes, la búsqueda pierde precisión. El chunking es una decisión técnica sorprendentemente importante: influye en si el sistema encuentra o no el punto correcto.
12.3 Un método de recuperación que funcione
La búsqueda por palabras clave no siempre basta. La búsqueda vectorial encuentra contenidos de significado parecido aunque las palabras no coincidan exactamente. A menudo la mejor solución es la búsqueda híbrida, que combina la búsqueda por palabras clave con la búsqueda semántica.
12.4 Mostrar las fuentes
El usuario debe poder ver en qué se basa la respuesta. Una buena respuesta con RAG puede incluir:
- el nombre del documento
- el apartado o la página
- un enlace a la fuente
- una breve justificación
- una advertencia de incertidumbre, si la fuente no basta
12.5 Instrucciones claras para el modelo
Al modelo hay que decirle cómo debe actuar. Por ejemplo:
«Responde únicamente a partir de las fuentes dadas. Si las fuentes no contienen la respuesta, dilo claramente.»
Esto reduce las conjeturas.
12.6 Evaluación y pruebas
Un sistema RAG hay que probarlo con preguntas reales. Amazon Web Services subraya la importancia de evaluar la fiabilidad de las aplicaciones RAG: conviene medir el sistema, entre otras cosas, desde el punto de vista del rendimiento, la fiabilidad y los posibles sesgos.[10]
Al hacer pruebas conviene preguntarse:
- ¿Se encuentra la fuente correcta?
- ¿La respuesta se basa en la fuente?
- ¿El modelo se abstiene de responder cuando falta información?
- ¿Ve el usuario las fuentes?
- ¿La respuesta suena demasiado segura?
- ¿Funciona el sistema para distintos grupos de usuarios?
Un buen RAG es un proceso continuo, no un proyecto puntual.
13. RAG frente a fine-tuning: ¿cuándo hace falta cada uno?
RAG se confunde a menudo con el fine-tuning del modelo. Son cosas distintas.
RAG
RAG da al modelo información externa en el momento de responder. Encaja cuando:
- la información cambia a menudo
- se quieren usar los documentos de la organización
- hay que mostrar las fuentes
- las respuestas deben mantenerse actualizadas
- se quiere evitar reentrenar el modelo
Fine-tuning
El fine-tuning consiste en seguir entrenando el modelo con un material concreto o para una tarea concreta. Es la opción adecuada cuando:
- se quiere cambiar el estilo del modelo
- se quiere enseñar un formato de respuesta concreto
- se quiere mejorar el rendimiento en una tarea acotada
- los datos son relativamente estables
- hace falta un comportamiento concreto, no solo información nueva
A menudo la mejor solución no es o lo uno o lo otro. Una empresa puede usar RAG para la información actualizada y el fine-tuning para enseñar, por ejemplo, un estilo de respuesta o un proceso concretos.
Pero si el problema es ”el modelo no conoce nuestras instrucciones más recientes”, RAG suele ser una solución más natural que el fine-tuning.
14. El futuro: de RAG a los agentes y a los sistemas inteligentes para el trabajo del conocimiento
RAG ya es importante hoy, y su peso crece a medida que la IA pasa de ser un simple chatbot a ser un agente.
Un agente es un sistema de IA que no se limita a responder una pregunta, sino que puede dar varios pasos: buscar información, comparar alternativas, usar herramientas, elaborar un plan e incluso ejecutar tareas.
Para esos agentes, RAG es infraestructura básica. Si un agente tiene que ayudar a una persona en su trabajo, necesita saber:
- qué dicen las directrices de la organización
- qué ha hecho antes el cliente
- qué ocurre en los sistemas
- qué normas hay que cumplir
- qué documentos se pueden usar
- en qué se basa la información
IBM describe el enfoque agentic RAG, en el que un sistema RAG se combina con capacidades de agente: el sistema puede recuperar información de una base de conocimiento externa y usarla para generar respuestas más precisas y específicas de un sector, sin que el modelo dependa solo de sus datos de entrenamiento.[11]
En el futuro, puede que el usuario no vea RAG como una técnica aparte. Lo verá en forma de mejores respuestas.
El usuario pregunta y el sistema:
- recupera las fuentes correctas
- evalúa si son suficientes
- compone la respuesta
- muestra las fuentes
- indica la incertidumbre
- propone el siguiente paso
Es un gran paso hacia una IA que no solo suena inteligente, sino que funciona de forma más fiable dentro del trabajo diario.
15. Conclusiones: ¿qué conviene aprender de todo esto?
RAG es una de las técnicas clave cuando la IA generativa se lleva al trabajo real. Resuelve tres grandes problemas:
- la información de la IA puede estar desfasada
- la IA no conoce los datos propios de la organización
- la IA puede alucinar de forma convincente
RAG no hace perfecta a la IA. Pero la hace más utilizable, más verificable y mejor anclada a información real.
Las lecciones más importantes son estas:
1. Con RAG, la IA primero busca información y solo después responde
Eso es lo que lo distingue de una respuesta normal de un modelo de lenguaje.
2. RAG reduce las alucinaciones, pero no las elimina del todo
Una búsqueda equivocada, una fuente antigua o una mala interpretación pueden seguir llevando al error.
3. Las fuentes son la gran fortaleza de RAG
Cuando la respuesta puede rastrearse hasta un documento, el usuario puede comprobarla.
4. La actualidad depende de la base de conocimiento
RAG es tan bueno como los datos que utiliza.
5. En las empresas, RAG es la clave para aprovechar el conocimiento interno
Puede convertir la intranet, la carpeta de documentos y el repositorio de instrucciones en una interfaz conversacional.
6. Con un asistente de IA basado en RAG, conviene pedir que se muestren las fuentes
Al usuario le conviene preguntar: ”¿En qué se basa esta respuesta?”
7. El mejor RAG a veces dice: «No lo sé»
Un sistema fiable no se inventa la respuesta si las fuentes no bastan.
El fondo de RAG es sencillo: la IA mejora cuando no tiene que responder sola.
Cuando el modelo cuenta con la información, las fuentes y el contexto adecuados, puede ayudar mucho más que un chatbot genérico. Ya no es solo una máquina de texto: es un buscador de información, un intérprete y un compañero de trabajo — siempre que la persona siga preguntando, comprobando y usando su propio criterio.
16. Prompts prácticos para usar un sistema RAG
A continuación tienes plantillas de prompts que puedes usar con cualquier solución de IA basada en RAG.
16.1 Respuesta basada en fuentes
Responde únicamente a partir de las fuentes disponibles.
Si la respuesta no está en las fuentes, di: ”No encuentro respuesta a esto en el material disponible”.
Añade al final de la respuesta las fuentes o los documentos en los que se basa.
16.2 Reconocer la incertidumbre
Responde a la pregunta a partir de las fuentes. Distingue en la respuesta:
1) qué dicen las fuentes con certeza
2) qué se puede deducir
3) qué no se puede deducir del material aportado
16.3 Comparación de documentos
Compara estas fuentes entre sí.
Busca contradicciones, solapamientos y puntos en los que un documento más reciente parece sustituir a otro más antiguo.
No saques conclusiones que las fuentes no respalden.
16.4 Respuesta de atención al cliente
Redacta una respuesta clara para el cliente a partir del material de origen.
Mantén un tono cercano y profesional.
No prometas nada que no digan las fuentes.
Si algo requiere la revisión de una persona, dilo con claridad.
16.5 Apoyo a la toma de decisiones
Haz un análisis conciso de este tema a partir del material de origen. Indica:
• los hechos más importantes
• posibles riesgos
• preguntas abiertas
• qué habría que comprobar antes de decidirNo añadas información externa sin señalarlo expresamente.
16.6 Revisión de una respuesta de RAG
Revisa tu respuesta anterior.
Marca cada afirmación clave con su fuente.
Si una afirmación no se apoya en una fuente, elimínala o márcala como suposición.
En resumen
Si el prompt engineering enseña a preguntar mejor a la IA, RAG le enseña a responder a partir de mejores fuentes. Esa es la diferencia decisiva.
Una IA normal puede sonar convincente. Una IA basada en RAG puede mostrar en qué se apoya su respuesta. Y justo eso la convierte en una técnica tan importante para las empresas, los profesionales y todo el que quiera usar la IA para algo más que generar ideas.
Consejo práctico: cuando uses un asistente de IA basado en RAG, pídele que muestre las fuentes y que avise si la respuesta no está en el material. Es una forma sencilla de generar más confianza en el uso de la IA.
Fuentes
- What is Retrieval-Augmented Generation (RAG)? — Google Cloud
- What is RAG? Retrieval-Augmented Generation AI — Amazon Web Services
- What is retrieval-augmented generation (RAG)? — IBM Research
- Vertex AI RAG Engine overview — Google Cloud Documentation
- What Is Retrieval-Augmented Generation aka RAG — NVIDIA Blog
- 5 key features and benefits of retrieval augmented generation — Microsoft
- O que é RAG (retrieval-augmented generation)? — IBM
- Understanding Retrieval Augmented Generation — AWS Prescriptive Guidance
- Deeper insights into retrieval augmented generation — Google Research
- Evaluate the reliability of RAG applications — AWS Machine Learning Blog
- What is Agentic RAG? — IBM